 NexAIX-官方博客
按量计费AI API怎么算月度成本?分时价差下的调度清单
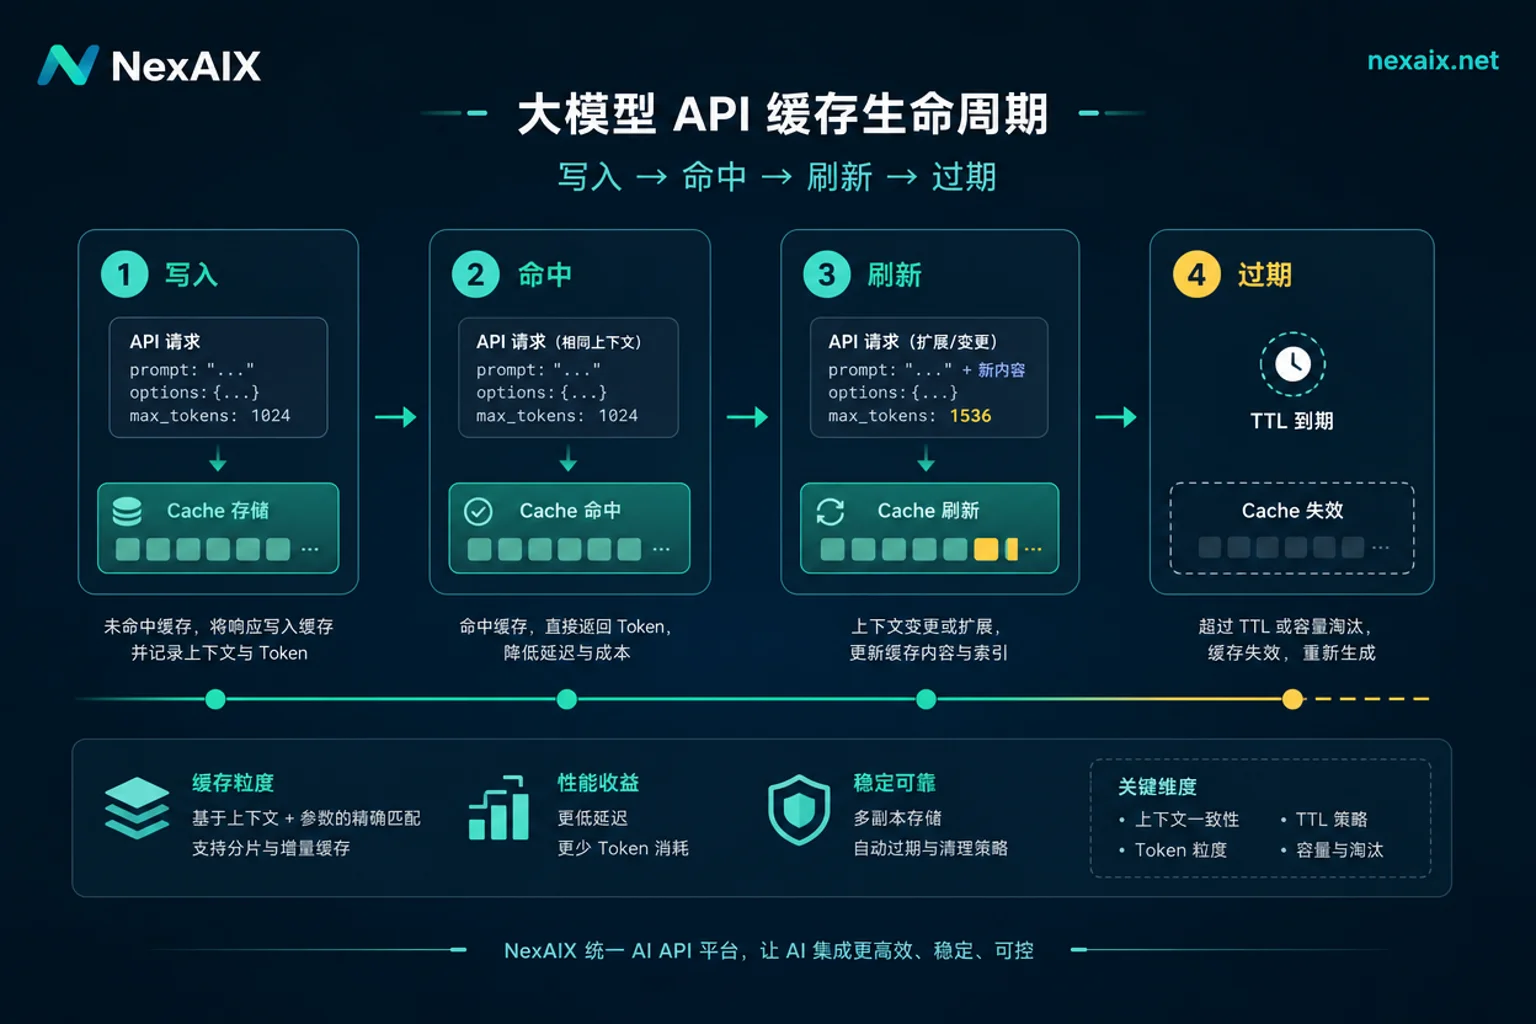
很多人以为按量计费AI API的月度成本只要算清输入和输出 token 量就够了,但这样得出的预算往往与实际账单差出一大截。真正的按量计费AI API月度成本公式至少包含四个维度:输入缓存未命中、输入缓存命中、输出,以及调用时段——前三者决定单价基准,第四个维度则可能让同样一批请求的最终费用相差两倍。以 DeepSeek 自 2026 年 8 月 16...
AI中转站怎么选?5项参数透传自测判据
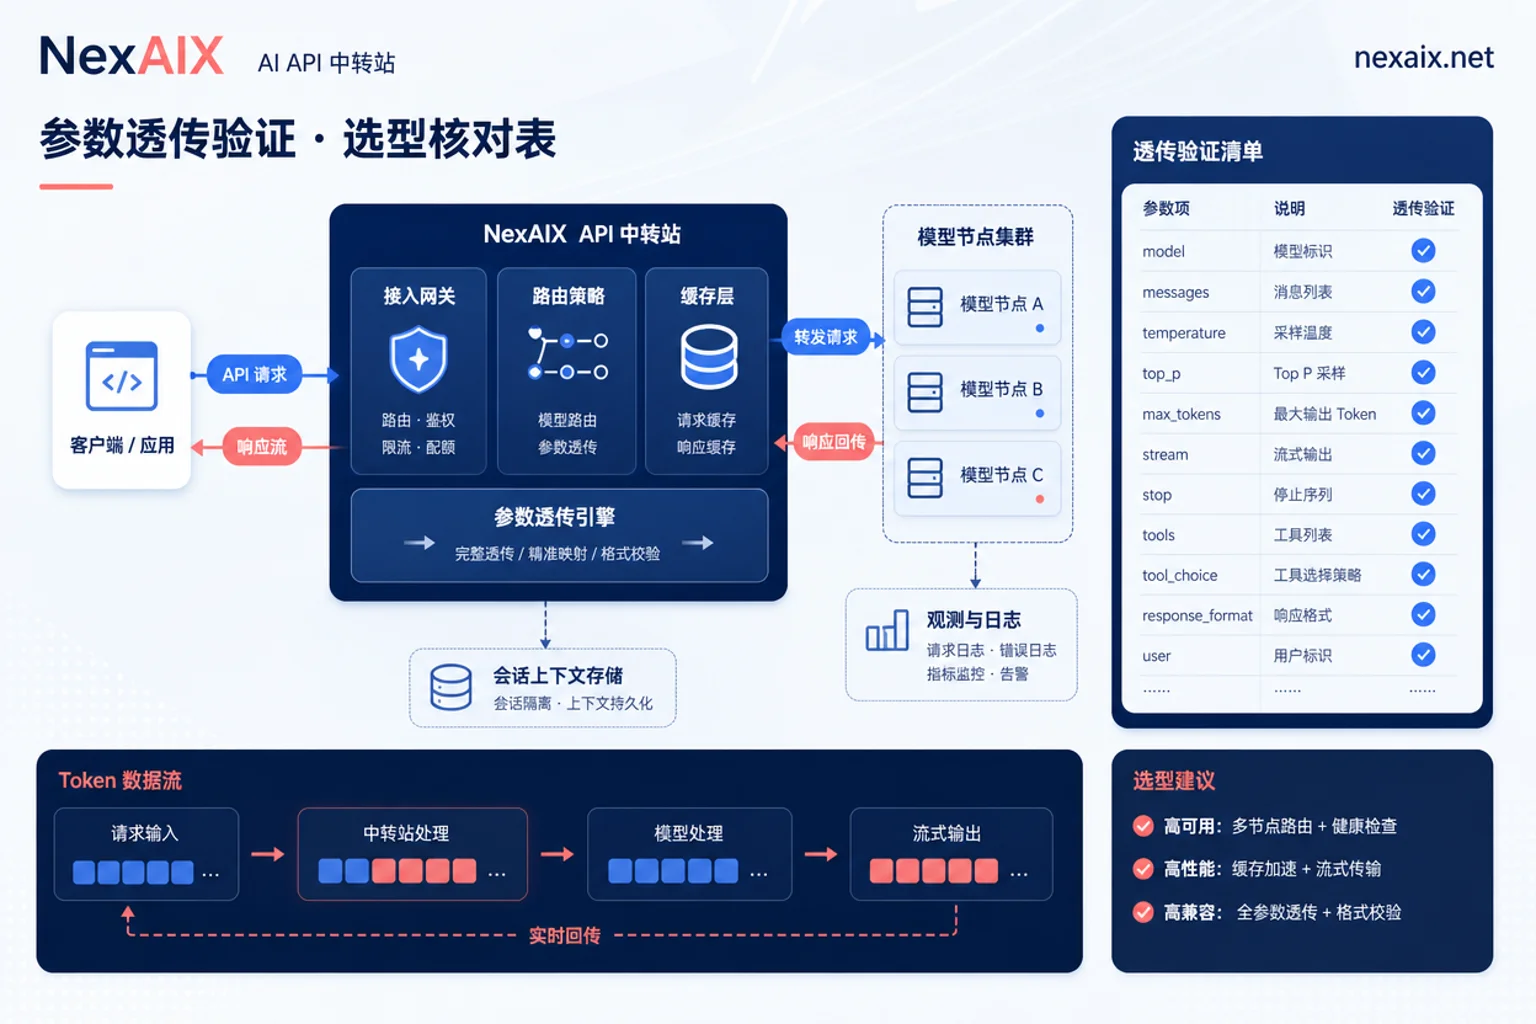
AI中转站怎么选?别急着比模型数量和单价,先看 5 项可当场发请求验证的透传判据:档位参数、缓存控制、模型规格、满载行为、计费口径。这五项决定了你上线后新特性能不能用、成本能不能算清、出问题时能不能追责,比价格更早决定成败。以 2026 年 8 月 5 日 OpenAI 为 GPT-5.6 系列 Fast mode 解除长上下文限制为例,超过 272K...
AI API延迟怎么压到100ms内?拆解可控环节与达标线
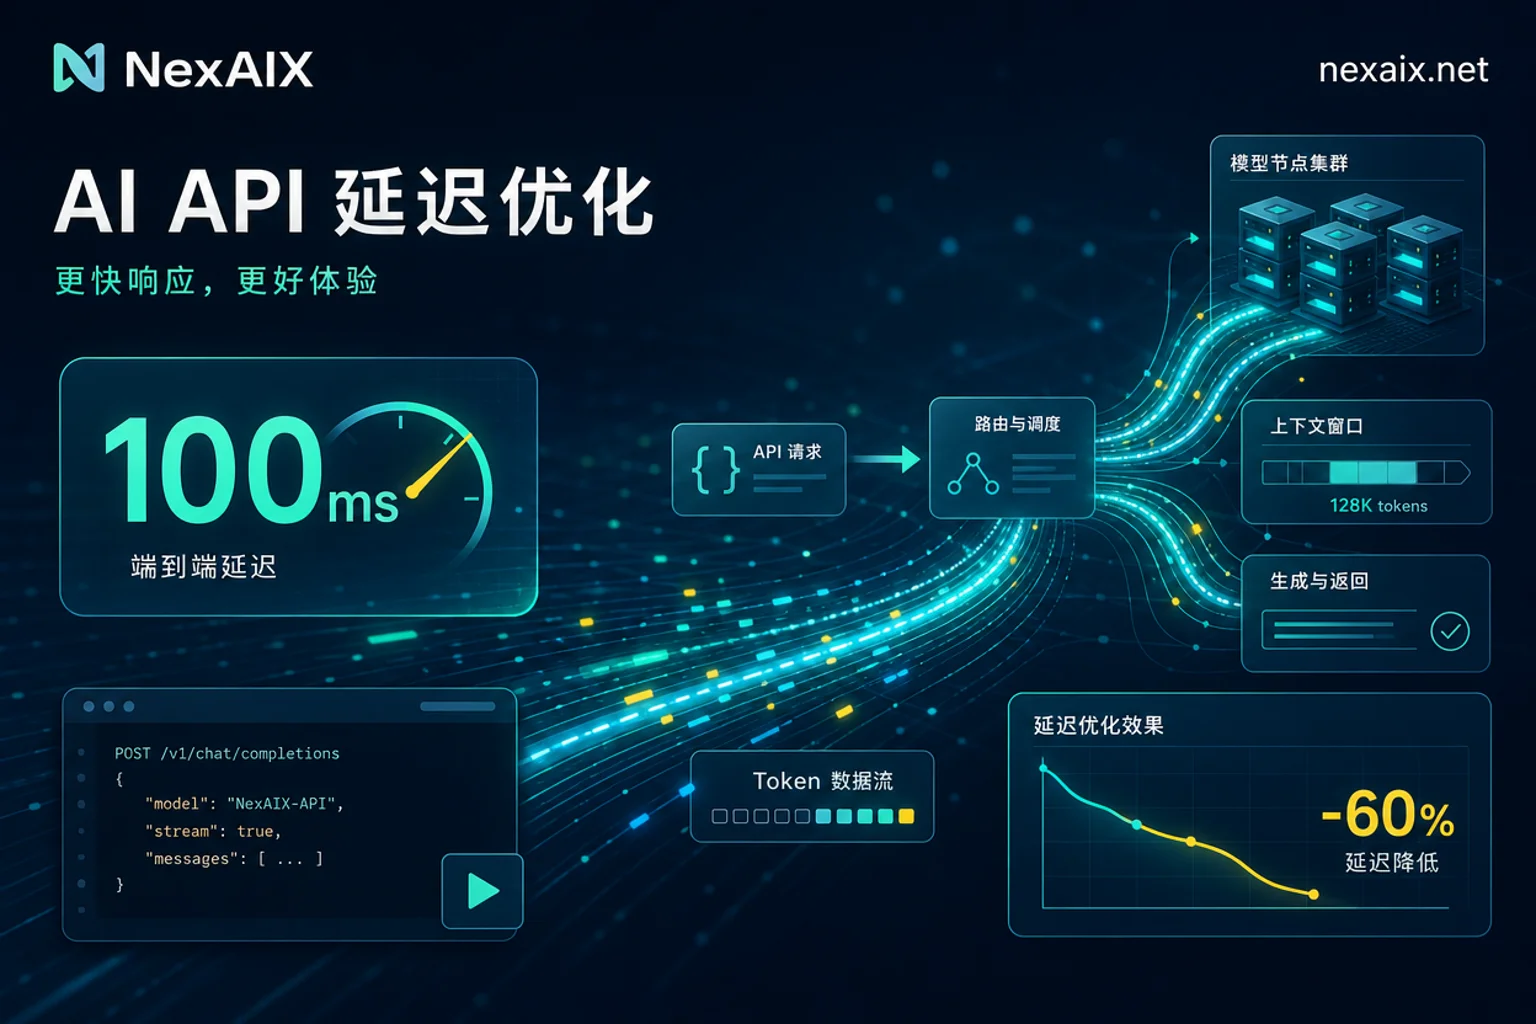
AI API延迟主要由客户端可控与服务商推理栈决定两部分构成,先分清TTFT与端到端再谈优化。2026年6月,Together AI与NVIDIA展示的推理栈已能把Agent前64词输出压进100ms,说明延迟优化正从“选模型”转向“选推理栈”。先分清三个数:TTFT、输出吞吐与端到端各自决定什么体验讨论AI API延迟,第一步不是调参,而是把三个容易...
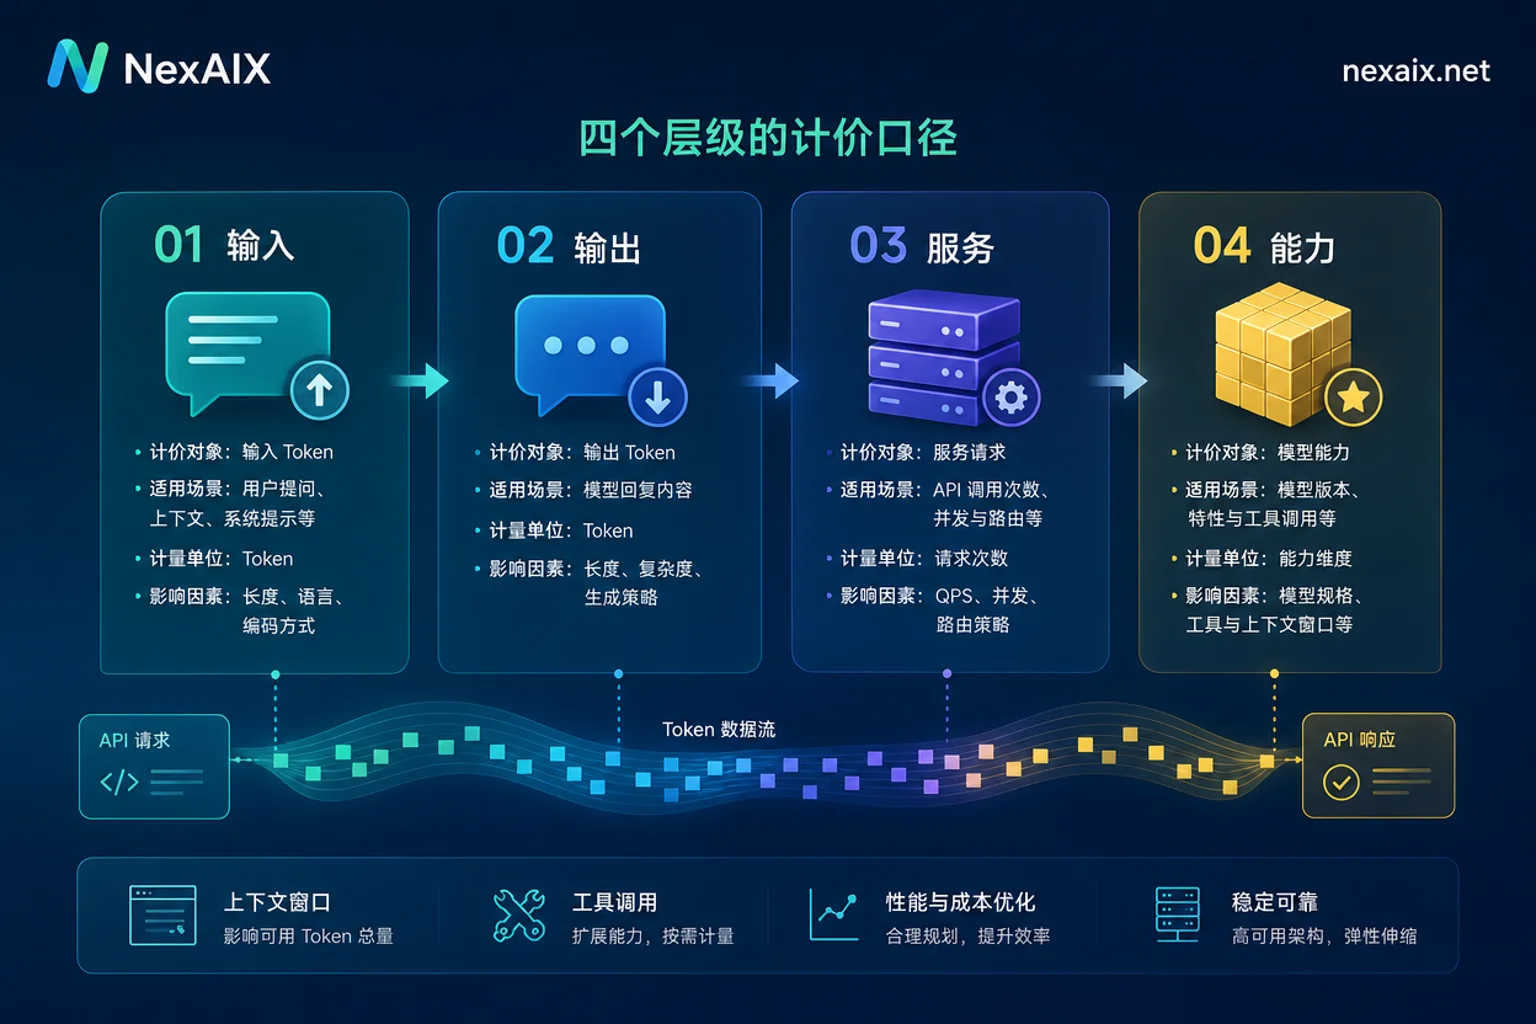
AI API价格怎么比?先统一四层计价口径再算
先给结论:AI API价格不能拿标价直接横向比,必须把输入档(缓存命中/未命中)、输出档、服务档位、能力档位四层口径统一后,再按自己实际请求分布折算成加权单价才有意义。2026年7月30日OpenAI对GPT-5.6阶梯调价、7月31日DeepSeek-V4-Flash-0731上线,两件事同时改写了当前比价基准,正好拿来做量级参照。口径一:输入 to...

