 NexAIX-官方博客
做AI模型评测,只看三个条件:可控的样本、固定的变量、可复现的结果。与其依赖公开榜单的分数,不如自己建一套业务对照集,用同一份数据、同一套代码,只换模型,把结论落在自己的调用链上。2026年8月,OpenRouter 推出针对 Agent 的实时检索基准与细粒度 Analytics API,把评测重心从静态榜单下沉到真实调用链——这正好印证了自建对照的必要性。
公开榜单能回答什么、不能回答什么
公开榜单能回答的是大致能力档位:哪个模型在通用任务上更强,适合纳入候选池。但它回答不了你的具体问题:你的 prompt 风格、你的数据分布、你的输出约束下,模型是否通过。榜单分数高但实际效果差,往往是因为评测样本与你的业务分布不一致。因此,AI模型评测的正确做法是:先用榜单圈定3-5个候选,再用自己的业务样本建对照集做最终决策。
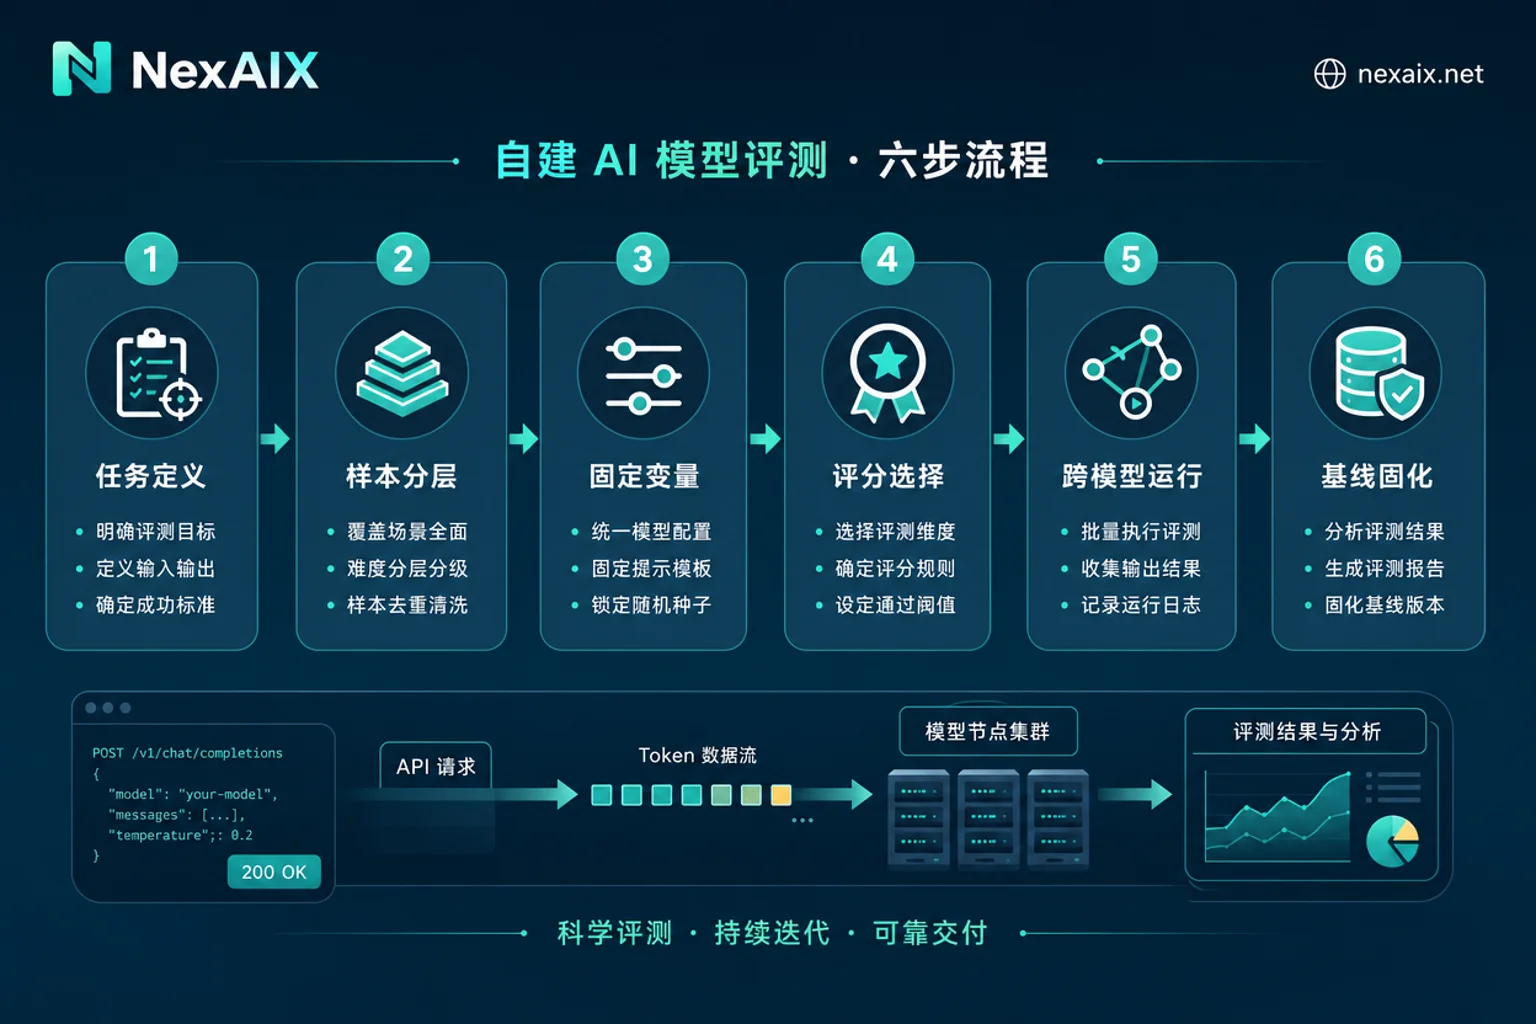
第一步:把评测目标写成可判定的任务定义
先别急着收集样本,把任务定义写清楚。一个可判定的任务定义包含三部分:
- 输入形态:字段类型、长度范围、语言、上下文来源。
- 输出约束:JSON Schema、字段必填、长度上限、格式要求。
- 通过条件:硬性失败项(如必填字段缺失、JSON解析失败)与打分项(如相关性、完整性)分开。
“可判定”意味着两个人独立评同一条样本,结论一致。如果做不到,先改定义再收样本。
以 RAG 问答为例,定义可以是:输入为问题与检索文档,输出需包含引用来源,且答案必须能由文档内容支撑;硬性失败项为无引用或引用不存在。结构化抽取则要求输出符合指定 Schema,字段缺失或类型错误即判失败。
第二步:AI模型评测集怎么分层,多少条样本才够
回答“评测集需要多少条样本才够”之前,先分层:按任务类型、难度、边界用例分桶,保证每桶有覆盖再谈总量。边界用例包括空值、超长上下文、对抗输入、多语言等。
样本量取决于两个因素:你想检出的最小差异和任务本身的方差。OpenAI 评测工程指南明确指出,置信区间与统计功效取决于样本量与任务方差——小样本检不出小幅真实退化,高方差任务需要更多样本和多次重采样。所以“十几条就能选型”只能排除明显不可用的候选,不能作为生产发布依据。实操上先跑30条冒烟测试,观察各桶通过率与方差,再按目标可检出差异递进扩样。
第三步:固定变量——把模型标识、采样参数和 prompt 版本写进记录
AI模型评测结果不一致时,先别怀疑模型,检查变量是否锁定。每条结果必须落盘以下字段:
| 字段 | 说明 |
|---|---|
| 请求 model | 你请求的模型名 |
| 返回体 model | 实际执行的模型名(必须核对一致) |
| temperature / top_p / seed | 采样参数 |
| prompt 版本号或哈希 | 锁定 prompt 变更 |
| 上下文长度 | 输入 tokens 数 |
| 时间戳 / 请求 ID / 状态码 | 可追溯性 |
固定 seed 和 temperature 只能降低非确定性,不能完全消除。因此要对同一条样本多次重采样(如3-5次),用通过率的方差评估稳定性。若结果漂移,先比对返回的 model 字段是否与请求一致——这比怀疑模型本身更优先。
第四步:评分方式怎么选——精确匹配、Schema 校验、模型评审与人工抽检
不同任务用不同评分方式,选错了会掩盖或放大差异:
| 任务类型 | 评分方式 | 要点 |
|---|---|---|
| 确定性答案(如分类、抽取) | 精确匹配或规则 | 定义等价规则,如同义词、格式归一化 |
| 结构化输出 | JSON Schema 校验 + 字段级比对 | 校验必填、类型、值域,再比对字段值 |
| 开放式生成(如总结、创作) | 模型评审 + 人工抽检 | 固定评审模型与评分 rubric,人工校准一致性 |
模型评审本身也是一个会漂移的变量,需要与被测模型同样记录版本和参数。人工抽检可按桶随机抽固定条数,每桶不少于数条,直到人工与评审模型的判定一致率稳定为止;一致率不稳时先调 rubric 再扩抽检量。
第五步:跨模型跑同一份集子,只换 model 参数
工程上,用 OpenAI 兼容接口做多模型对照最简单:同一份数据加载、同一套 prompt 渲染、同一套评分器,模型作为唯一变量循环。这里可以借助 NexAIX:其提供 OpenAI Chat Completions 兼容端点 https://api.nexaix.net/v1,同一套评测脚本只换 model 参数即可完成跨模型对照。返回体的 model 字段对应实际执行模型,满载时返回标准 429 错误而不静默切换更便宜的模型——这两点正是评测结果可归因、可复现的前提。
建议先用测试额度跑小规模冒烟集,验证脚本与评分器,再扩到完整评测集。并发时注意退避处理,避免限速导致的样本缺失被误读成能力差异。具体可用模型与规格以 NexAIX 当前模型页为准。
第六步:把结果固化成回归基线,什么时候必须重跑
基线快照应包含:数据集版本、prompt 版本、模型标识、采样参数、各桶通过率与方差、判定阈值。判定阈值应基于基线方差设定,而不是拍脑袋的绝对分数——方差大时,阈值要放宽,避免因为随机波动误判退化。
触发重跑的事件包括:换模型、模型版本或别名变更、prompt 改动、上下文策略调整、供应商切换。把重跑触发条件写进 CI,每次变更自动执行评测,才能持续守护质量。
黑盒自动路由为什么会破坏AI模型评测的对照前提
自适应路由能降低探索门槛、动态优化成本,但在评测与回归测试中,它会让实际执行模型与请求模型不一致,单一变量假设失效。判定方法:核对返回的模型标识,观察满载时是降级还是返回 429,用同一条样本重复请求看模型字段是否变化。探索阶段可以用路由,评测与基线阶段必须显式锁定模型。更多细节可参考:AI API选型:自动路由还是锁定模型 和 多模型API网关的静默降级检测。
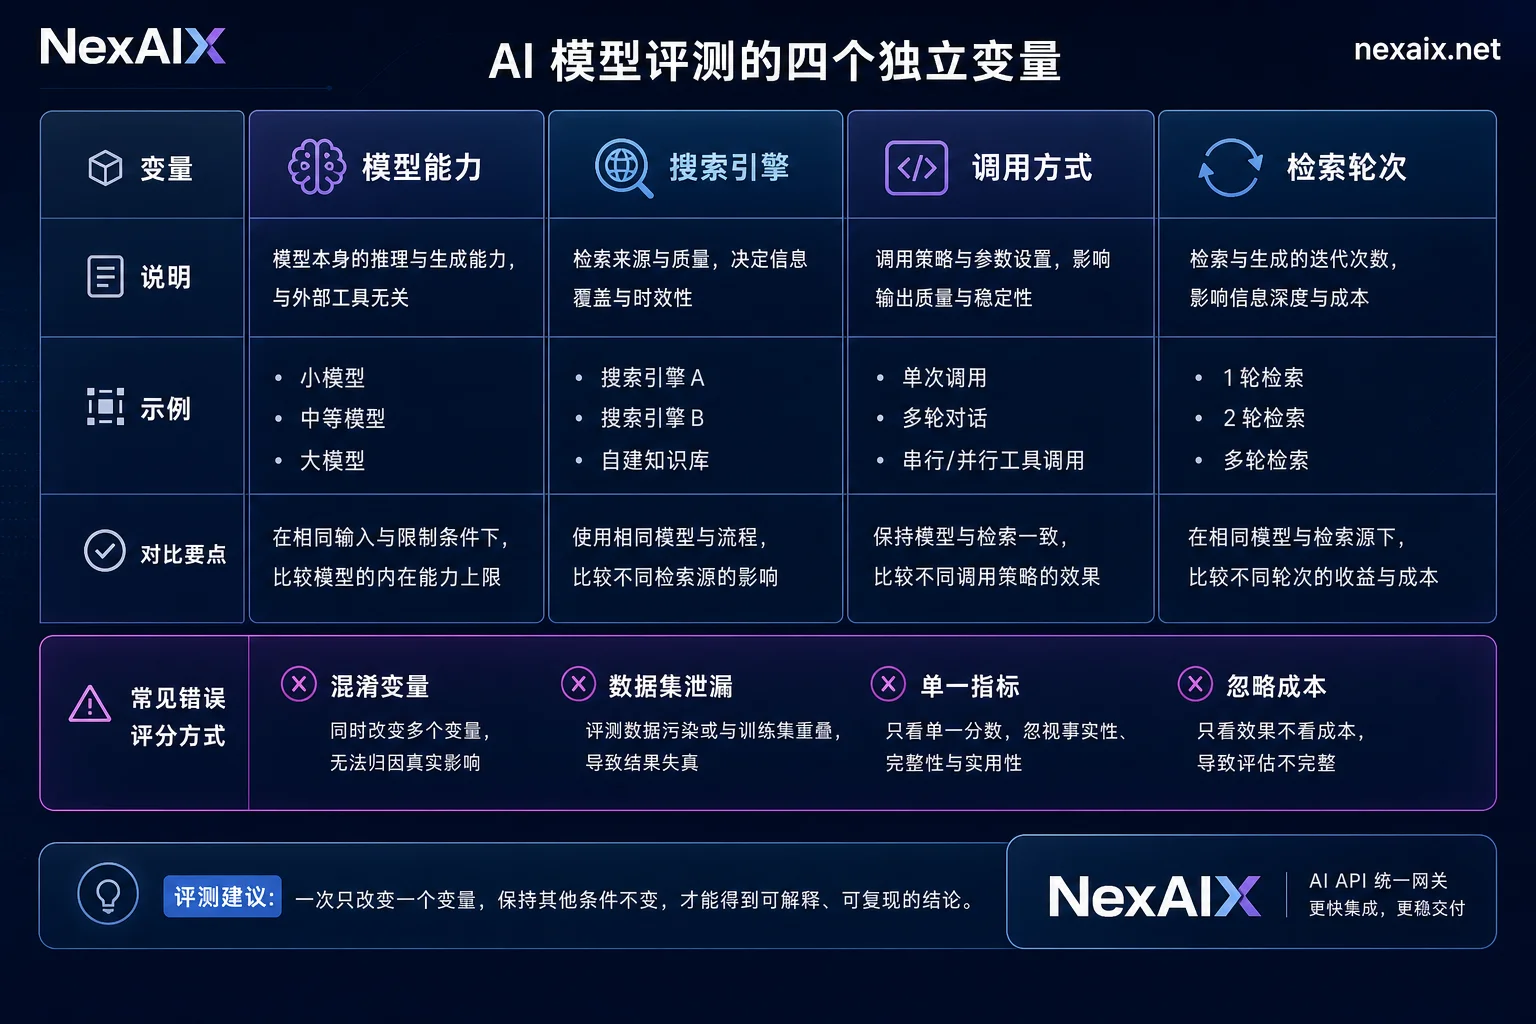
检索类链路要单独评:引擎、深度与模型是三个变量
Agent 联网检索效果评测,不能把模型和检索混在一起测。OpenRouter 2026年8月的做法是把模型能力、搜索引擎、调用方式与检索轮次预算(1/5/25轮)拆成独立变量分别对照——混在一起测,检索质量问题会被误判成模型能力问题。设计对照时,固定模型,只变搜索引擎,或固定引擎,只变检索轮次。额外记录字段:检索轮次、命中来源数、是否触发工具调用。
本周可执行的评测落地清单
照这份清单核对一遍,AI模型评测的每个变量都能落盘可查。
| 检查项 | 通过标准 |
|---|---|
| 任务定义可判定 | 两人独立评同一条样本结论一致 |
| 分桶覆盖边界用例 | 含空值、超长、对抗、多语言至少各1条 |
| 样本量与方差匹配 | 高方差任务已多次重采样 |
| 参数与模型标识落盘 | 每条结果含 model、temperature、seed、prompt 版本 |
| 评分器版本固定 | 评审模型与 rubric 已记录版本 |
| 并发与 429 处理 | 有退避策略,样本无缺失 |
| 基线快照归档 | 含数据集、prompt、模型、参数、方差、阈值 |
| 重跑触发条件写进 CI | 换模型、prompt 改动自动触发评测 |
常见问题
评测集需要多少条样本才够?
没有固定数字,取决于方差和你想检出的最小差异。先按任务分桶保证边界用例覆盖,用一小批真实样本(约 30 条冒烟集)验证脚本与评分器,再根据目标最小差异与桶内方差递进扩样——方差越大、要检出的差异越小,所需样本越多;小样本只能排除明显不可用的候选,不能作为发布依据。
换模型后 eval 结果不一致怎么办?
按顺序排查:先核对返回体 model 是否与请求一致,再检查 temperature/seed 是否固定,然后确认 prompt 版本没变,最后考虑采样方差——多次重采样估计波动。若以上都正常,才怀疑模型本身有变化。
要不要用模型当评委?
可以用,但必须固定评审模型与评分 rubric,并记录版本。评审模型本身会漂移,所以要用人工抽检校准一致性,抽检可按桶随机抽固定条数(每桶不少于数条),直到人工与评审模型的判定一致率稳定为止。若人工与评审分歧大,先调整 rubric。
benchmark分数高但实际效果差是什么原因?
榜单样本与你的业务分布不一致,或者你的任务约束(如输出格式)在榜单中未体现。另外,榜单可能只测单轮,而你的场景是多轮交互。解决方法是自建对照集,用真实业务样本评测。
换供应商后要重跑哪些项?
至少重跑全部基线:因为供应商可能通过不同路由导致实际执行模型不同。重跑时先核对返回的 model 字段,确认执行模型一致。若供应商不支持显式模型锁定,考虑切换或增加校验。
关于锁模与变量控制的更多工程细节,可参考 OpenAI兼容API 的 model 迁移与回归验证 和 AI API 429 报错排查与重试退避。
先按第一步写出任务定义、挑 30 条真实业务样本跑一次冒烟集,确认脚本与评分器可用后再扩量;跨模型对照时把返回体的 model 字段一并落盘,确认执行模型与请求一致。



评论(0)