 NexAIX-官方博客
AI API选型时,建议这样决策:弱约束的自由文本链路可以放开自动路由,而强 Schema 约束与多步工具调用链路必须显式锁定模型。这个结论在 2026 年 8 月变得更加重要——OpenRouter 于 8 月 10 日上线了 Wisdom of the Market 驱动的 Auto Router,通过聚合全平台调用分布替代静态分类器,并在响应体 model 字段返回实际执行模型,同时还推出了 Analytics API 用于用量归因。下面六条判据构成一套可执行的 AI API选型检查表:输出确定性、结构化稳定性、成本上限、可复现 eval、故障归因、合规审计。
先分清两件事:模型选择权交给谁,与请求最终跑在哪台机器上
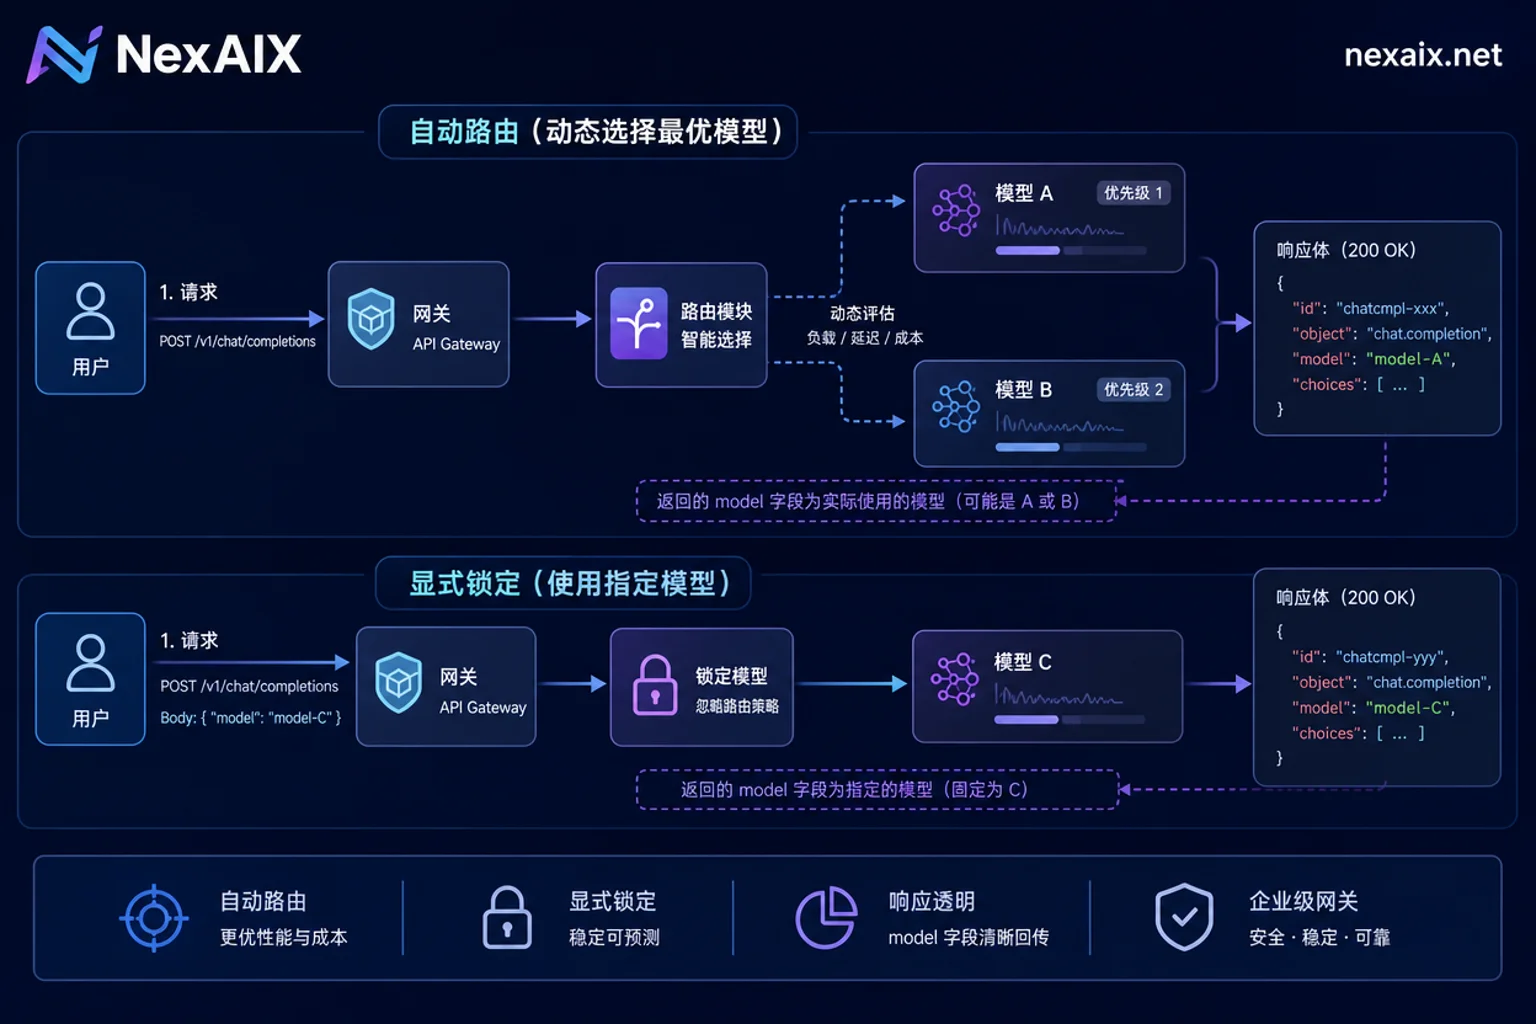
做 AI API选型时,首先要区分两个概念:自动路由(换模型名)与供应商侧负载调度(同一模型的不同实例)。前者会改变输出分布与工具调用协议,是本文讨论的核心;后者只是同一模型在不同机器上的调度,不改变输出特性。判定入口很简单:查看响应体的 model 字段,如果它在同一请求场景下会变化,那就是自动路由在起作用;如果稳定不变,只是底层实例在变,则不影响你的业务逻辑。网关侧的容灾与调度差异,可参考多模型API网关的拆解。
判据一:输出确定性——同一 prompt 跨模型漂移能不能被业务接受
第一条判据是可量化的漂移测试。固定一组 prompt、固定采样参数(temperature、top_p 等),重复 N 次请求,统计关键字段的一致率。阈值需按业务失败代价自定——写库或对外披露类链路通常要求接近 100%,内部草稿生成可放宽;本文举例的数值仅作占位,不是行业基准。如果一致率低于业务阈值,则自动路由带来的确定性损失不可接受。来自 LLMRouter/xRouteBench 的评测指出,跨模型动态切换在强结构化输出上会导致确定性下降。这是结构性现象,不是偶发故障。对于金融、医疗等需要严格一致性的场景,建议直接锁定模型。
判据二:多模型路由导致json格式不稳定怎么办——结构化输出为什么最先退化
在 Agent 工作流中,不同底层模型对 JSON Schema 严格模式的支持度、工具调用协议、参数遵循存在结构性差异。跨模型静默切换极易引发下游解析器崩溃,这是社区实践中总结出的典型问题。LangChain 与 NeMo Switchyard 的多模型分流实验(2026-06 工程记录)显示,工具绑定与参数 Schema 遵循依赖底层模型的精确支持,跨模型静默切换会引发下游语义解析失败。如果你的链路依赖严格 JSON 输出或工具绑定,那么自动路由带来的不确定性是最大的风险。可埋点两个指标:解析失败率(JSON 语法错误比例)与工具参数校验失败率(参数格式或缺失比例)。一旦这些指标在放开路由后明显上升,应立即回退到锁定模型。
判据三:成本可预测性——自动路由下怎么估上限而不是估平均
关于自动路由成本能不能预估的问题,答案是:只能估上限,不能依赖平均节省。成本上限估算公式为:命中模型单价区间的最高价 × 请求量 + 重试与解析失败导致的重发开销。例如,如果路由可能命中从便宜到贵的多个模型,按最贵模型单价作为上限预算,同时把解析失败导致的额外请求计入成本。不要被宣传中的成本节省百分比所迷惑,实际开销取决于动态命中分布与重试频率。工程经验表明,成本预估应始终基于最坏情况。
判据四:换模型后eval结果不可复现——锁定模型是对照评测的前提
换模型后 eval 结果不可复现是常见痛点。原因是离线回归 eval 需要固定模型名、固定参数、固定数据集,才能把指标变化归因于模型或提示词改动。如果让自动路由介入评估流程,你无法判断指标波动来自路由切换还是代码变更。正确的顺序是:先在锁定模型下跑出可复现的基线,再灰度放开路由做 A/B 对比。这样你才能自信地说某项优化确实有效。注意,即使放开路由,也需要定期复跑基线,确保路由策略没有悄悄降低质量。关于模型迁移后的评测口径,可参考OpenAI兼容API 的 model 迁移。
判据五:故障归因——出问题时你能不能定位到具体模型与供应商
当生产环境出现质量下降或解析错误时,你需要能回溯到具体模型与供应商。这要求请求 ID、实际执行模型、状态码、重试次数等字段完整记录。如果自动路由没有提供这些信息,故障会变成不可复现的谜团。OpenRouter 的 Analytics API 正是为此设计,但并非所有网关都提供同等粒度的数据。在 AI API选型时,应把“能否按请求维度追踪实际执行模型”作为一项硬性要求。如果缺少这些字段,建议立即切换到锁定模型,直到补全观测能力。
判据六:合规与审计——返回体 model 字段和用量日志要能对上账
从审计视角,响应体中的 model 字段必须对应实际执行模型,用量记录必须与计费口径一致。否则,财务审计和合规审查会面临对不上账的风险。可拿两条口径当核对基线——返回体 model 字段是否对应实际执行模型、满载时是否返回标准 429 而非静默换模型;NexAIX 公开的服务口径即按此执行,读者可用测试额度锁定单个模型发几十次请求,比对响应 model 字段与用量日志是否逐条对得上。如需进一步排查,可参考AI中转站掺水怎么查。
分流规则:哪些链路交给自动路由,哪些必须显式锁定
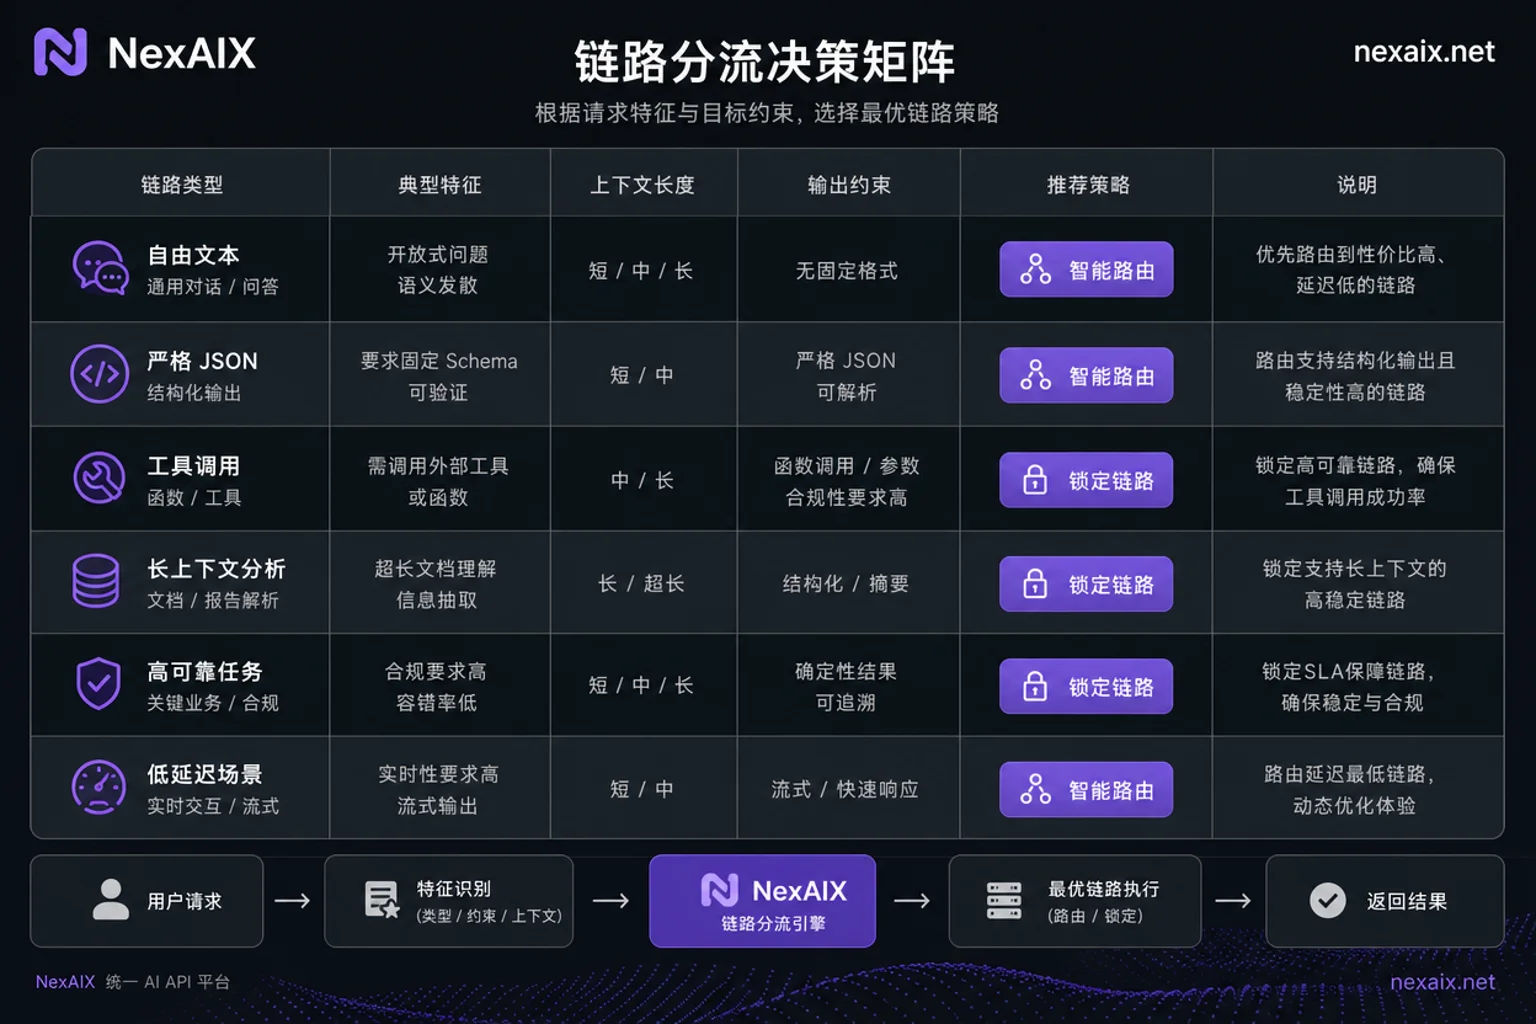
以下分流决策表可以帮助你快速判断,适合用于 AI API选型时对齐团队认知。
| 链路类型 | 输出形态 | 失败代价 | 建议策略 |
|---|---|---|---|
| 自由文本对话 | 非结构化 | 低(可接受轻微漂移) | 放开自动路由 |
| 严格 JSON 输出 | 强 Schema | 高(解析崩溃) | 显式锁定模型 |
| 多步工具调用 | 结构化+工具绑定 | 高(语义失败) | 显式锁定模型 |
| 数据入库写入 | 严格格式 | 高(数据污染) | 显式锁定模型 |
| 受合规审计链路 | 任意 | 中(需可追溯) | 显式锁定模型 |
| 低成本探索链路 | 非关键 | 低 | 放开自动路由 |
注意,混合策略是可行的:同一个应用内,不同链路可以采用不同策略。例如,面向用户的闲聊功能放开路由,而 Agent 的工具调用链路锁定模型。
回退清单:从自动路由切回锁定模型要跑的回归项
如果你决定从自动路由回退到锁定模型,请按以下清单回归,避免遗漏关键项。
- [ ] model 字段核对:确认响应体 model 为锁定模型,无静默切换
- [ ] Schema 解析通过率:回归 JSON 解析成功率,应回到基线水平
- [ ] 工具调用参数校验:验证工具参数格式与必填项符合预期
- [ ] 长上下文截断行为:检查长输入下的截断策略是否一致
- [ ] 429 与重试行为:确认满载时返回标准 429,触发合理重试;若回退后仍频繁触发限流,见AI API 429 报错排查
- [ ] 成本对账:核对用量日志与计费账单,确保与锁定模型单价一致
- [ ] eval 基线复跑:在同一数据集上重跑离线评测,对比历史基线
完成这些回归项,你才能有把握地说回退是安全的。
常见问题
自动路由会不会悄悄换模型?
自动路由确实可能在不同的请求间切换模型,但通常会在响应体中通过 model 字段返回实际执行模型。若响应体 model 与你请求的模型名长期不一致且文档未说明路由策略,应先在测试环境固定模型复测,再决定是否把该链路交给该网关。
怎么知道网关实际调用的是哪个模型?
最直接的方法是检查响应体的 model 字段。更严格的做法是在网关或代理层记录每次请求的 model、token 数、时间戳,形成审计日志。若网关提供了 Analytics API(如 OpenRouter 的),可以利用它做用量归因分析。缺少这些数据,你就无法回答“到底用了哪个模型”。
Agent 工具调用要不要固定模型?
建议固定。因为工具调用依赖底层模型对工具 Schema 和指令的精确遵循,跨模型切换极易导致参数格式错误或协议不兼容,进而引发下游解析崩溃。在一个复杂的 Agent 工作流中,工具调用的失败代价通常很高,固定模型可以保证行为的一致性,也有利于排障和评测。
自动路由成本能不能预估?
只能估上限,不能依赖平均节省。上线首两周按最贵候选模型单价做预算封顶,同时用网关用量归因数据统计实际命中分布,两周后再把预算收敛到 P95 命中价位。
JSON 格式不稳定怎么先止血?
如果 JSON 解析失败率上升,最直接的止血手段是显式锁定模型名,然后重新测试解析成功率。同时检查网关是否开启了 Schema 严格模式支持,并确保工具的参数校验逻辑有容错。在锁定模型下解决稳定问题后,再考虑是否以及如何重新引入自动路由。



评论(0)