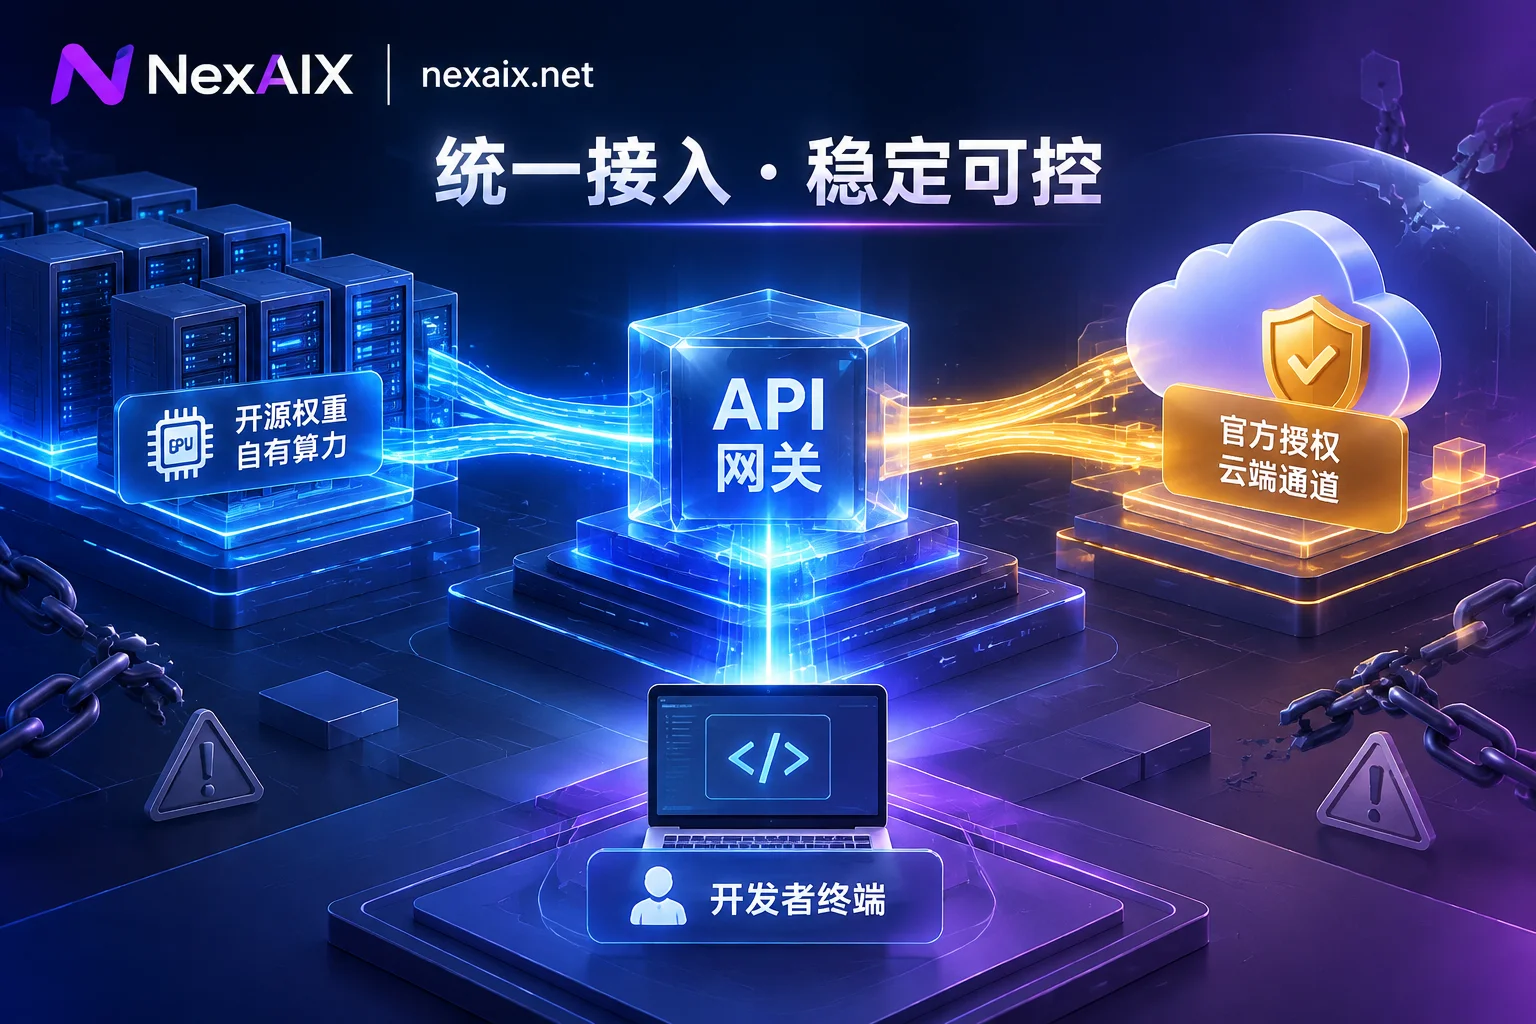
NexAIX-官方博客
2026 年,大模型应用从早期的 Demo 验证全面迈入生产级落地,但支撑应用底层的 AI API中转站 市场却经历了一轮剧烈的行业洗牌。
一方面,海外与国内多家模型大厂密集升级了反欺诈与风控机制。今年年中以来,针对利用 sub2api 技术将个人订阅账号(如 Plus/Max 会员、编程订阅套餐)逆向转为 API 接口低价倒卖的灰色中转站,各大厂商展开了大规模封号与限流清退;不少依赖“共享号池”的应用在业务高峰期突然中断。另一方面,据 CISPA 2026 独立研究报告(arXiv:2603.01919)对全球中转端点的实测数据显示,高达 45.83% 的受测中转端点未通过模型身份核验——修改返回名称、暗中替换为轻量级模型、截断上下文窗口或强行降低量化精度等“掉包降智”行为,已成为开发者选型时最大的隐形陷阱。
当业务从“能调通就行”走向“敢不敢上生产”,开发者、Agent 研发团队以及维护线上稳定性的技术负责人,究竟该如何评估和选择一个可靠的 AI API 中转站?
一、 为什么灰色“号池中转”撑不起生产环境?
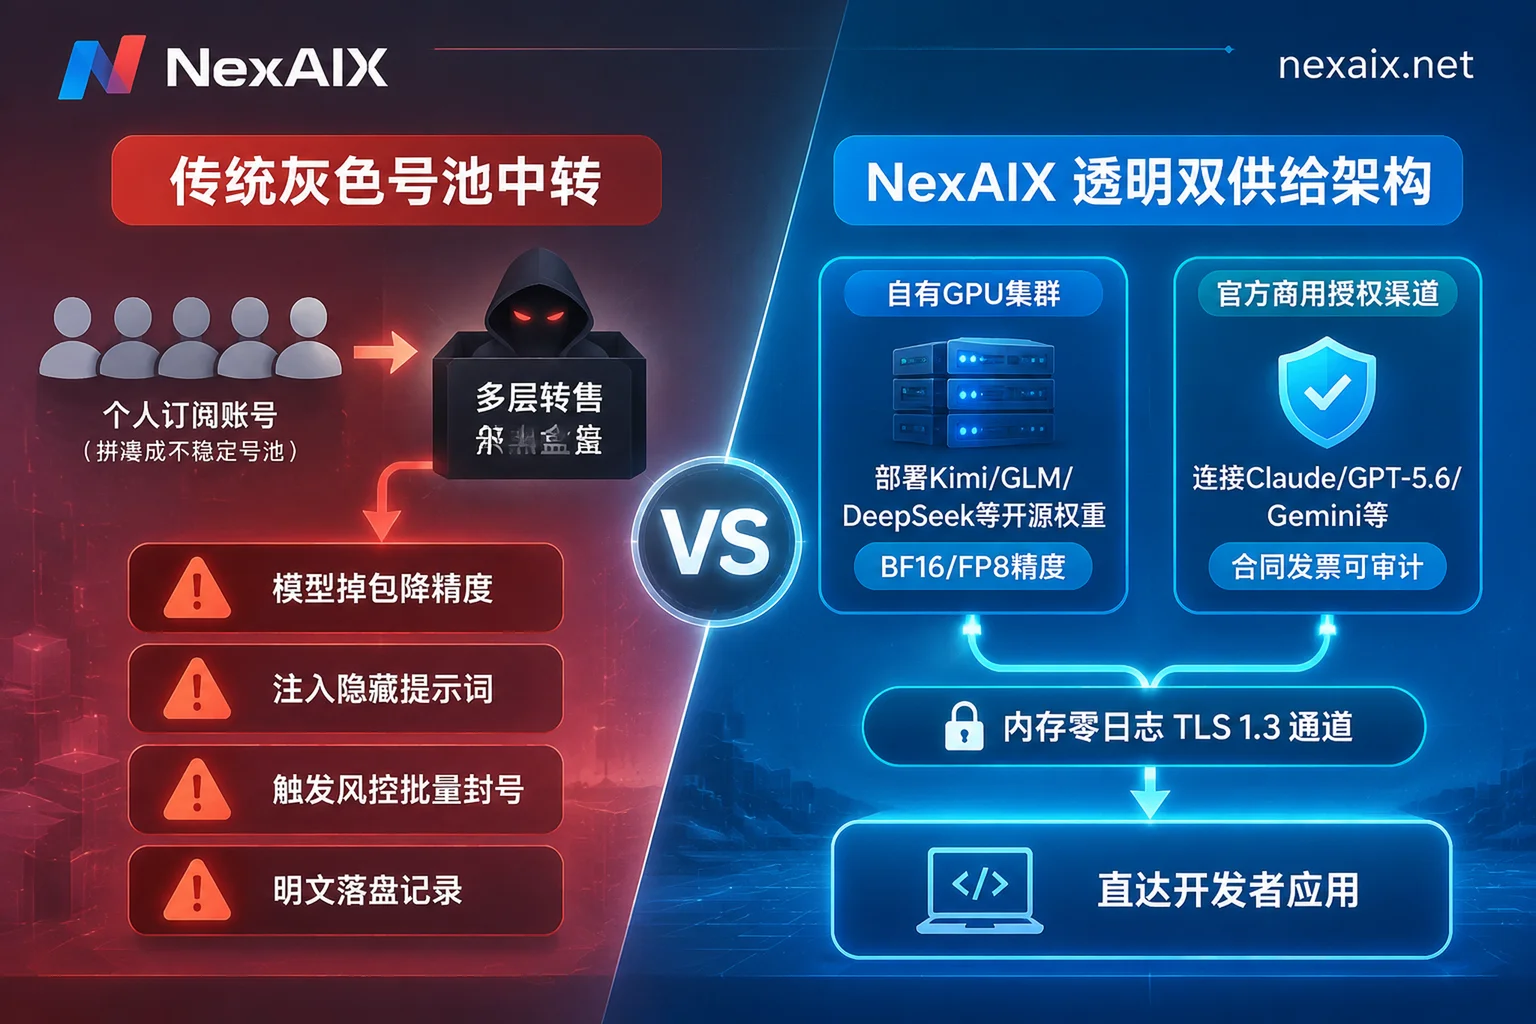
在早期的个人开发阶段,许多开发者为了解决跨境网络延迟或繁琐的多平台注册问题,曾尝试过价格低廉的小型中转服务。但在 2026 年的技术与合规环境下,传统的“号池拼车”与“多层转售”模式暴露出三大致命伤:
- 链路脆弱与连带封禁:依赖逆向客户端协议、盗刷额度或凑单号池的平台,一旦触发上游厂商的设备指纹与并发风控,整个渠道会在瞬间返回大量报错,甚至直接卷款关停。
- 隐性“降智”导致 Agent 逻辑崩溃:在复杂的多轮工具调用(Tool Use)或长文档分析场景中,如果中转站在后台偷偷注入精简输出的隐藏 System Prompt,或者将高阶模型偷换为小尺寸模型、强行压缩上下文,前端业务就会出现 JSON 解析失败、指令遗忘等难以排查的诡异 Bug。
- 数据裸奔与财务合规缺失:多层转手的中转站往往将用户的 Prompt 明文落盘记录,甚至倒卖用于微调训练;同时由于缺乏合法主体与正规发票,企业团队根本无法走通财务报销与安全审计流程。
要彻底避开这些雷区,选型的第一步就是穿透 API 网关的表象,审查服务商底层的算力与渠道供给方式。
二、 生产级 AI API 中转站的四大硬核选型标准
以 NexAIX 的架构实践为例,一个能够直接承载生产环境流量的 AI API 中转站,必须在渠道源头、模型保真、流控机制与数据合规四个维度给出透明、可验证的承诺。
1. 供给源头透明:只做“自有算力”与“官方授权”
真正稳定的 API 聚合平台,绝不碰个人订阅号池,也不做二手额度的多层转售。在 NexAIX 的渠道透明度说明中,所有模型严格限定为以下两种供给方式(并在每个模型详情页顶部公开标注):
- 自有算力部署(开源权重模型):将官方发布的开源权重直接部署在自建与自租机房的自有 GPU 集群上,由团队自主运维,不转售任何第三方额度。目前官网已覆盖 Kimi、GLM、DeepSeek、MiniMax、Qwen、gpt-oss 等主流开源系列。每个模型页均明确标注上下文长度、最大输出、许可协议以及实际的推理精度(如
BF16、FP8、MXFP4等,按模型如实标注,想了解不同精度的差异可参考《模型推理精度 BF16 和 FP8 有什么区别》)。如果团队有清单以外的开源权重模型需求,还可以直接注明型号与预计用量发送邮件至 [email protected],评估算力后会直接回复排期。 - 官方授权渠道(闭源商业模型):针对 Claude、GPT-5.6、Grok、Gemini 等闭源系列,全部走厂商官方商用授权渠道,有正规合同、有发票、可审计,绝不使用号池或逆向客户端协议。闭源模型的容量受上游配额约束,极大程度杜绝了因违规调用导致的封号断流风险。
2. 原版模型不降配:参数原样透传,支持四步自查
针对行业内普遍存在的“模型掉包”焦虑,NexAIX 坚持原版模型不降配原则:返回体里的 model 字段就是实际执行的模型;不换小模型、不降推理精度、不截断上下文和最大输出、不注入隐藏系统提示词,请求中的 temperature、top_p、max_tokens 等参数原样透传。
更重要的是,“不掺水”不能只靠口头承诺,开发者完全可以通过以下四种工程方法自行核验(详见《怎么确认 API 返回的是不是原版模型:四类可复核的检查方法》):
- 固定 Prompt 与随机种子复测:在相同参数下对比输出分布与逻辑推理深度。
- 核对响应体
model字段:检查返回报文中的模型标识是否与请求及官方规范严格一致。 - 接近上限的长度压测:直接构造接近模型标称上限的输入或要求长输出,验证是否存在隐性截断。
- 复述消息测试:要求模型完整复述收到的全部消息内容,排查网关层是否偷偷塞入了要求“简短回答”的隐藏 System Prompt。
3. 确定性的高并发与限流机制:拒绝“静默降级”
在生产环境中,流量洪峰与突发并发是常态。一些中转站为了掩盖算力不足,会在后台将超额请求静默路由到更便宜、更弱的模型上,或者让请求无限期挂起导致客户端连接池耗尽。
在 NexAIX 的吞吐与限流设计中,系统采取了清晰、可预期的工程边界:
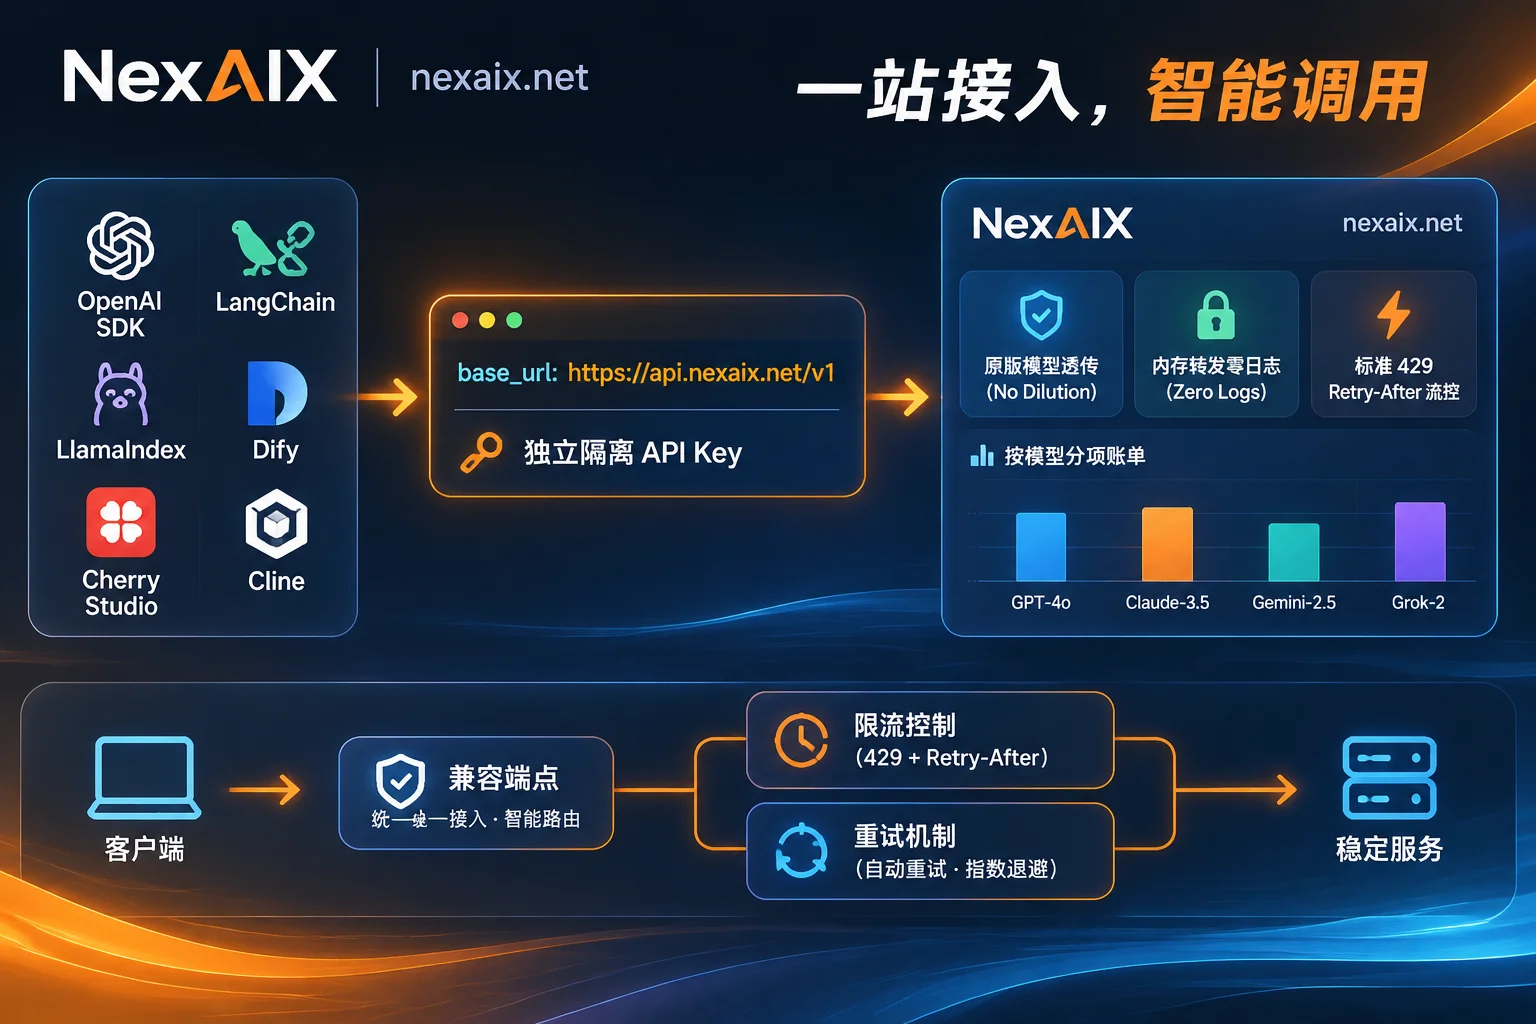
- 每把 API Key 设有独立的 RPM(每分钟请求数)、TPM(每分钟 Token 数)和并发上限;若业务增长需要更高配额,可随时提交申请,平台按实际算力与上游容量如实答复。
- 满载时返回标准 HTTP
429状态码并附带Retry-After响应头,绝不无限期挂起,也绝不私自改用更便宜的模型顶替。 - 由于 NexAIX 坚持单一供应方、单一端点的透明调用,不做黑盒式的自动路由与故障转移,收到
429后,由业务方自己在代码层决定执行指数退避重试、排队还是切换备用模型,让架构师对系统行为拥有 100% 的控制权(相关高可用设计可参考《大模型 API 生产环境高可用与安全指南》)。 - 全部模型均支持流式输出(Streaming),帮助前端应用在超长输入场景下有效平滑首 Token 延迟(TTFT)。
4. 零对话日志、多 Key 隔离与企业级合规
对于企业研发与 SaaS 团队而言,数据安全与账单治理直接决定了项目能否通过安全合规审查:
- 本站侧不记录对话内容:在 NexAIX 零日志架构下,用户的
prompt和completion仅在内存中完成转发,请求结束即刻释放,不写盘、不用于训练,也不转给做训练的第三方;从客户端到推理节点全程采用 TLS 1.3 加密传输。平台仅保留用于账单核算与排障的元数据(请求 ID、模型名、Token 计数、时间戳、状态码)。 - 客观透明的上游留存说明:对于闭源模型,请求到达厂商侧后的数据留存按各厂商条款执行,本站不作虚假的越权代承诺。目前官网仅在明确核实过的两个 Claude 模型页单独标注了上游留存策略(其中 Opus 5 支持零数据保留,Fable 5 目前有 30 天留存),其余均以官方条款为准(延伸阅读:《怎么验证 AI API 有没有记录对话内容》)。
- 按 Key 隔离与清晰账单:支持创建多把 API Key,每把 Key 拥有独立配额、独立权限与独立用量账单,账单按模型分项统计,控制台支持随时导出用量明细;一旦某把 Key 发生泄露,可单独吊销而不影响其他业务线。每次调用均返回唯一请求 ID,排障时带着请求 ID 即可快速定位。
- 合同与发票齐全:平台具备正规企业主体,支持签订服务协议与数据处理协议(DPA),开具正规发票;针对有严苛合规要求的团队,还可发送邮件至 [email protected] 洽谈独立资源池与私有化部署评估。
三、 极速迁移实战:一行代码接入开源与闭源全系模型
在解决了稳定性与合规顾虑后,接入或迁移的工程成本如何?
NexAIX 严格按照 OpenAI Chat Completions 规范实现无缝兼容接入。无论是流式输出、函数/工具调用(Function Calling / Tool Use)还是多轮对话,均与原生规范保持一致;对于支持多模态的模型(具体见各模型页的“输入模态”标注),图像可直接按 OpenAI 多模态格式传入 image_url 或 base64,视频则按抽帧后的图像序列传入。
这意味着,正在使用 OpenAI SDK、LangChain、LlamaIndex、Vercel AI SDK 的代码库,或者日常使用的 Dify、Cherry Studio、NextChat、Cline、OneAPI 等客户端工具,绝大多数只需做两步改动:
- 将
base_url替换为https://api.nexaix.net/v1 - 换上在 NexAIX 控制台 获取的 API Key
代码示例:同一端点无缝切换闭源与开源模型
借助一把 Key,开发者可以在同一套代码里同时调用官方授权的闭源旗舰模型与自有算力部署的开源权重模型,切换模型只需修改 model 字段(详细迁移检查清单可参阅《换大模型 API 要改哪些代码》):
from openai import OpenAI

# 仅需修改 base_url 和 api_key,无需引入五花八门的厂商专属 SDK
client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key=" NEXAIX_API_KEY "
)

def chat_with_model(model_name: str, user_prompt: str):
    response = client.chat.completions.create(
        model=model_name,
        messages=[
            {"role": "system", "content": "你是一个严谨的生产环境架构助手。"},
            {"role": "user", "content": user_prompt}
        ],
        temperature=0.2,
        stream=True
    )
    for chunk in response:
        if chunk.choices[0].delta.content:
            print(chunk.choices[0].delta.content, end="", flush=True)

# 场景 A:调用官方授权渠道的闭源模型处理复杂架构规划
# 具体可用模型 ID 请以 https://nexaix.net/models/ 列表为准
chat_with_model("gpt-5.6", "请设计一个基于 HTTP 429 Retry-After 的指数退避重试伪代码。")

# 场景 B:只改 model 字段,无缝切换至自有算力集群的开源权重模型处理高频任务
chat_with_model("glm-5.2", "将上述伪代码转化为带类型注解的 Python 函数。")
💡 查阅模型文档的小贴士:
在访问单个模型详情页查阅三步接入代码与规格参数时,URL 中的slug需将模型 ID 里的点(.)替换为横线(-)。例如查看glm-5.2的详情页应访问https://nexaix.net/models/glm-5-2/(直接用点号拼接访问会返回 404),而在 API 请求代码里的model字段依然填写原模型 IDglm-5.2。
四、 结语:让基础设施回归确定性
2026 年的 AI 应用竞争,早已不再是谁能找到更便宜的“灰产羊毛渠道”,而是谁的 Agent 响应更稳、谁的上下文不丢细节、谁的数据链路经得起客户与监管的审计。
如果您正在为首次接入大模型 API 寻找省心的统一入口,或是正打算将线上业务从不稳定的中转渠道迁移出来,现在只需使用邮箱即可在 NexAIX 控制台 (api.nexaix.net) 完成注册——无需企业资质,注册即送测试额度。不妨立刻拿您手头最核心的业务 Prompt 和压测脚本,亲自跑一跑原版模型的真实表现。