 NexAIX-官方博客
稳定AI API生产落地指南:告别Agent调用链雪崩、隐式降配与挂起故障
在单轮问答或简单文本生成场景中,大模型接口偶发的抖动通常只会导致单个用户点击一次“重新生成”。但在2026年的生产环境中,企业落地的核心早已转向多步推理与工具编排的 AI Agent(智能体)。
当一个业务请求在后台被拆解为 10 到 20 次连续的模型调用、函数调用(Function Calling)和上下文回填时,底层接口的微小瑕疵会被指数级放大。技术团队在排查线上事故时往往会发现:压垮 Agent 系统的通常不是干脆利落的报错,而是上游算力来源不明导致的突发中断、网关在负载高峰期偷偷替换小模型引发的“语义崩溃”,以及请求满载时无限期挂起导致的连接池耗尽。
要让复杂应用在生产环境平稳收敛,评估稳定AI API的标准必须从单纯的“连通率”升级为“全链路行为的可预测性”。本文将从多步调用的工程痛点出发,拆解生产级大模型 API 底座的建设标准与实战方案。
一、 为什么多步 Agent 对 API 稳定性的要求极其苛刻?
在传统的微服务架构中,接口稳定性主要看网络延迟和 HTTP 500 错误率。但在大模型驱动的 Agent 架构下,入口流量与底层 LLM 调用呈 1:N 的并发放大关系,且面临两类极具破坏性的隐蔽故障:
1. 算力“暗箱”引发的语义级故障
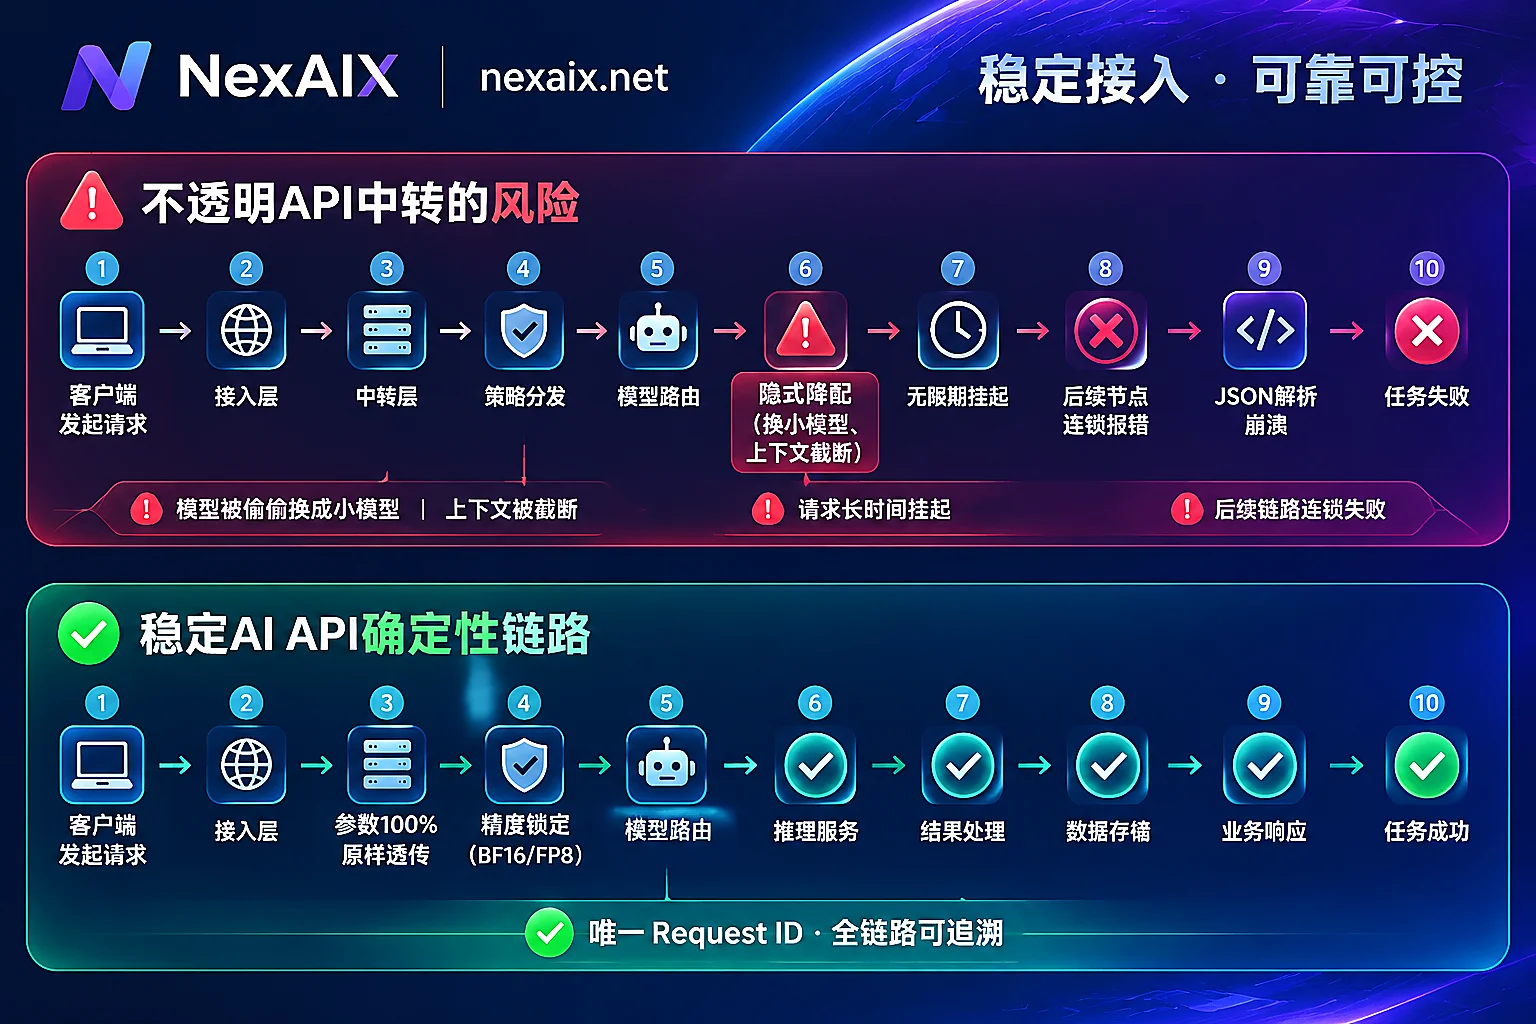
如果单次 API 调用存在 2% 的异常率,一个包含 15 个步骤的 Agent 工作流完整跑通的概率就会跌至 $0.98^{15} \approx 73.8\%$。更致命的是静默降级(Silent Degradation):部分不透明的 API 代理商为了在高峰期维持表面上的“高可用”或压低成本,会在后台动态截断输入上下文、降低模型推理精度,甚至将发往旗舰模型的请求暗中路由给廉价的轻量模型。
对于强依赖指令遵循和 JSON 结构化输出的 Agent 而言,这种“掉包”不会触发 HTTP 报错,却会导致模型在第 5 步突然漏掉必填的工具参数、输出残缺的 JSON,或者在长上下文检索中丢失关键状态,最终引发整个业务链路的逻辑雪崩。
2. 无限期挂起与客户端重试风暴
大模型推理属于长耗时、高资源消耗的操作。当上游算力满载时,如果服务端不按规范返回限流信号,而是将 HTTP 连接长时间挂起(Hang),业务侧的工作线程和连接池会被迅速占满。一旦客户端超时并触发盲目重试,成倍的积压请求瞬间涌入,就会将局部算力紧张演变为全局的服务瘫痪。
二、 重新定义“稳定AI API”的四大工程基石
针对上述生产痛点,一个真正能够支撑核心业务的稳定 AI API,必须在算力源头、参数透传、流量控制和隔离排障四个维度提供确定性的工程保障。这也是 NexAIX 在构建 API 基础设施时严格遵循的底线:
1. 供给源头透明:彻底告别号池与逆向协议
许多线上突发断流,根源在于使用了基于个人账号池轮询(如各类 sub2api 方案)或逆向客户端协议的灰产中转(延伸阅读:2026 AI API中转站选型与避坑指南)。这类渠道随时面临上游封号与策略风控。
在 NexAIX 的供给体系中,所有模型仅采用两种合规透明的供给方式(详见供给透明性说明):
- 自有算力部署(开源权重):针对 Kimi、GLM、DeepSeek、MiniMax、Qwen、gpt-oss 等官方开源权重系列,直接部署在自建与自租机房的自有 GPU 集群上,由团队自主运维,绝不转售第三方额度。每个模型页均明确标注上下文窗口、最大输出、推理精度(如 BF16、FP8、MXFP4 等)及开源许可。
- 官方授权渠道(闭源模型):针对 Claude、GPT-5.6、Grok、Gemini 等闭源商业模型,全线走厂商官方商用授权渠道,有正规合同、有发票、可审计,绝不使用号池或逆向客户端协议。
2. 原样执行不降配:保障推理质量的确定性
为了杜绝 Agent 链路中的“语义漂移”,API 服务端必须保证每一次响应都出自开发者指定的原版模型。NexAIX 严格执行不降配标准:
- 模型与精度保真:返回体中的
model字段即为实际执行推理的模型;绝不暗中替换为小模型、不降低标称的推理精度。 - 参数与上下文零篡改:不截断标称的上下文长度和最大输出限制,不注入任何隐藏的系统提示词(System Prompt);客户端传入的
temperature、top_p、max_tokens等核心超参数均原样透传至推理节点。 - 支持随时复核:技术团队可随时通过固定 Prompt 与随机种子复测、核对返回体
model字段、执行接近上限的长度压测,或要求模型复述收到的全部消息这四种方法进行交叉验证(详见怎么确认 API 返回的是不是原版模型)。
3. 可预期的背压控制:标准 429 与 Retry-After
面对突发流量洪峰,稳定的 API 不应做“黑盒式”的自动降级,而应向客户端传递清晰的背压(Backpressure)信号。
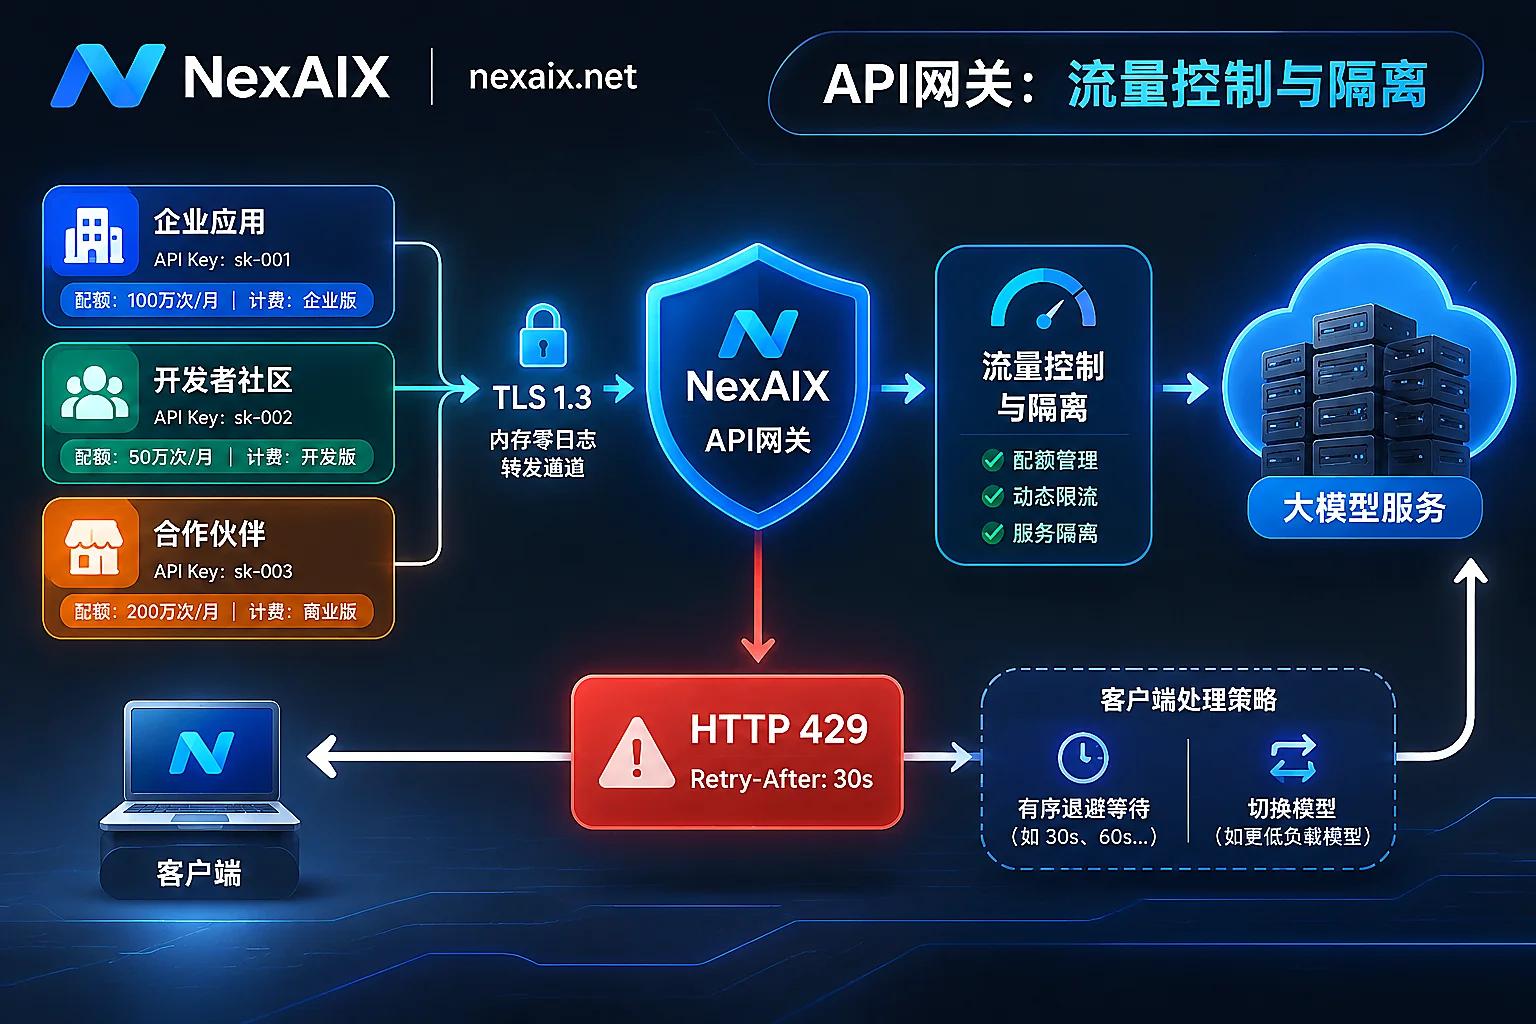
在 NexAIX 的吞吐与限流机制中,开源模型容量由自有 GPU 集群支撑,闭源模型受上游配额约束。每把 API Key 设有独立的 RPM(每分钟请求数)、TPM(每分钟 Token 数)和并发上限(如需更高配额可联系评估扩容)。当遇到算力满载或触发速率限制时,系统会立即返回标准的 HTTP 429 状态码,并在响应头中附带明确的 Retry-After 等待秒数。
服务端绝不会让请求无限期挂起占用客户端连接,更不会自作主张将请求偷偷转发给更便宜的模型。把控制权交还给业务架构——由开发者的编排层根据业务优先级,自主决定是按 Retry-After 退避等待、放入异步队列,还是显式切换到备用模型。
4. 内存级零日志转发与多 Key 隔离治理
生产环境的稳定性同样包含安全合规与故障隔离:
- 对话内容不落盘:在 NexAIX 侧,请求的
prompt和completion仅在内存中完成转发,请求结束即刻释放,绝不写入磁盘,不用于模型训练,也不转交给任何做训练的第三方;从客户端到推理节点全程采用 TLS 1.3 加密(参见零日志与隐私保护)。对于闭源模型,请求到达上游厂商后的数据留存按各厂商条款执行(目前仅 Claude 的两个模型页单独标注了上游留存政策:Opus 5 支持零数据保留,Fable 5 目前有 30 天留存)。 - 按 Key 隔离与精准排障:支持创建多把 API Key,每把 Key 拥有独立配额、独立权限和按模型分项的独立用量账单。一旦某个业务模块的 Key 发生泄露或异常调用,可单独吊销而不影响其他核心服务(参考:大模型 API 生产环境高可用与安全指南)。同时,系统仅保留请求 ID、模型名、Token 计数、时间戳和状态码等基础元数据;每次调用均返回唯一的请求 ID,线上排障时只需携带该 ID 即可快速定位链路状态。
三、 生产级接入实战:遵循 Retry-After 的稳健调用代码
NexAIX 严格按 OpenAI Chat Completions 规范实现,完整支持流式输出(Streaming)、函数/工具调用、多轮对话及多模态输入(图像按标准格式传 image_url 或 base64,视频按抽帧后的图像序列传入)。
对于已经在使用 OpenAI SDK、LangChain、LlamaIndex、Vercel AI SDK,或 Dify、Cherry Studio、NextChat、Cline、OneAPI 等工具的团队,只需将 base_url 改为 https://api.nexaix.net/v1 并换上 NexAIX 的 Key,即可用一把 Key 调用平台上全部已开通的开源与闭源模型(详见快速接入指南)。
以下是一段面向生产环境的 Python 调用示例。它展示了如何利用单一端点无缝切换模型,并在遇到 429 限流时严格读取 Retry-After 响应头进行退避重试,同时记录请求 ID 以便生产排障:
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

# 仅需修改 base_url 和 api_key 即可无缝迁移现有项目
client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key="sk-your-nexaix-key",
    timeout=60.0,       # 显式设置客户端超时,防止异常网络挂起
    max_retries=0       # 关闭 SDK 默认盲目重试,由业务层精准控制 Retry-After
)

def call_llm_reliably(model_id: str, messages: list, max_attempts: int = 4):
    """
    生产级调用封装:遵循 Retry-After 背压信号,记录请求 ID,支持显式切换模型
    """
    for attempt in range(1, max_attempts + 1):
        try:
            response = client.chat.completions.create(
                model=model_id,
                messages=messages,
                temperature=0.2,
                max_tokens=2048,
                stream=False  # 生产环境长文本建议开启 stream=True 降低首字等待焦虑
            )
            # 核对返回体中的实际执行模型,确保未发生隐式降配
            actual_model = response.model
            request_id = response.id
            print(f"[Success] Model: {actual_model} | Request ID: {request_id}")
            return response.choices[0].message.content

        except RateLimitError as e:
            # 捕获标准 429 响应,优先读取服务端返回的 Retry-After 头部
            retry_after_str = e.response.headers.get("Retry-After") if e.response else None
            if retry_after_str and retry_after_str.isdigit():
                wait_seconds = int(retry_after_str) + random.uniform(0.1, 1.0)
            else:
                # 兜底:指数退避 + 随机抖动 (Jitter)
                wait_seconds = min((2 ** attempt) + random.uniform(0, 1), 30)

            req_id = e.request_id or "unknown"
            print(f"[429 RateLimit] Attempt {attempt}/{max_attempts} | Request ID: {req_id}. "
                  f"Waiting {wait_seconds:.2f}s before retry...")

            if attempt == max_attempts:
                raise RuntimeError(f"Max retries reached for {model_id}. Last Request ID: {req_id}") from e
            time.sleep(wait_seconds)

        except APIStatusError as e:
            # 捕获其他 HTTP 状态码异常,保留请求 ID 供快速排障
            print(f"[API Error] Status: {e.status_code} | Request ID: {e.request_id} | Message: {e.message}")
            raise

# 示例:同一套代码,仅修改 model 字段即可在开源集群与闭源授权模型间切换
if __name__ == "__main__":
    prompt_messages = [{"role": "user", "content": "请输出一段用于解析订单状态的 JSON Schema。"}]

    # 调用自有算力部署的开源权重模型(注意:请求中 model 字段保留原始点号,如 glm-5.2)
    result = call_llm_reliably(model_id="glm-5.2", messages=prompt_messages)
print(result)工程提示:在查阅模型列表及单个模型详情页时,请注意网页 URL 的 slug 会将模型 ID 中的点号替换为横线(例如访问https://nexaix.net/models/glm-5-2/查看上下文、推理精度与三步接入代码;直接拼接/models/glm-5.2/会返回 404),但在 API 请求的代码里,model字段仍需填写标准的glm-5.2。此外,超长输入场景下首 Token 延迟和费用会随输入长度自然上升,建议在生产代码中全面开启流式输出(stream=True)。
四、 架构师上线前的 API 稳定性核查清单
在将 AI 应用或 Agent 工作流推向生产环境前,建议技术负责人对照以下清单完成底座验收:
| 核查维度 | 劣质/灰产中转常见隐患 | 生产级稳定 API 标准(NexAIX) | 业务侧架构配合建议 |
|---|---|---|---|
| 算力与渠道合规 | 个人号池轮询、逆向网页端协议,随时面临大面积封号断流 | 自有算力部署(开源权重自建/自租 GPU 集群)+ 官方授权渠道(闭源商用合同、可开票、可审计) | 根据任务复杂度组合开源与闭源模型,在模型目录核对供给标签与许可 |
| 推理质量一致性 | 高峰期暗中切换低配模型、截断上下文、篡改系统提示词 | 100% 原样透传不降配,返回体 model 即实际执行模型,标明 BF16/FP8/MXFP4 等精度 | 上线前执行固定 Seed 复测与极限长度压测,确保长链路 Agent 逻辑不漂移 |
| 过载与限流表现 | 连接长时间挂起不返回,或偷偷路由到廉价模型凑数 | 满载时立即返回标准 HTTP 429 并附带 Retry-After,绝不挂起或静默换模型 | 客户端关闭无脑重试,读取 Retry-After 实施退避,或由业务层显式决定切备用模型 |
| 安全隔离与可观测 | 单一 Key 混用所有业务,明文记录对话日志,报错无追踪凭据 | 内存转发不写盘(TLS 1.3 加密);按 Key 独立配额与分项账单;每次调用返回唯一 请求 ID | 按环境(Dev/Prod)或微服务拆分独立 Key,结构化日志中强制记录每次调用的请求 ID |
五、 结语:把确定性留给底层,把创造力留给业务
大模型的演进速度极快,但生产环境对稳定、合规、透明的要求从未改变。与其让研发团队把精力耗费在应对上游封号、排查静默降配导致的诡异 Bug 上,不如从一开始就选择边界清晰、行为可预期的 API 基础设施。
现在即可访问 NexAIX 控制台 使用邮箱免费注册——无需繁琐的企业资质审核,注册即送测试额度,几分钟内即可获取 API Key 完成真机验证与用量明细导出。
如果您所在的团队与企业需要签署正式商用合同、开具增值税发票、签订服务协议(SLA)与数据处理协议(DPA),或者有清单以外的开源权重模型排期需求、独立资源池及私有化部署需求,欢迎随时发送邮件至 [email protected](请附上预计用量或合规场景说明),我们的工程团队将结合实际算力容量为您提供一对一的评估与支持。