NexAIX-官方博客
大模型 API 输出被截断怎么办:先看 finish_reason,再按原因逐条修
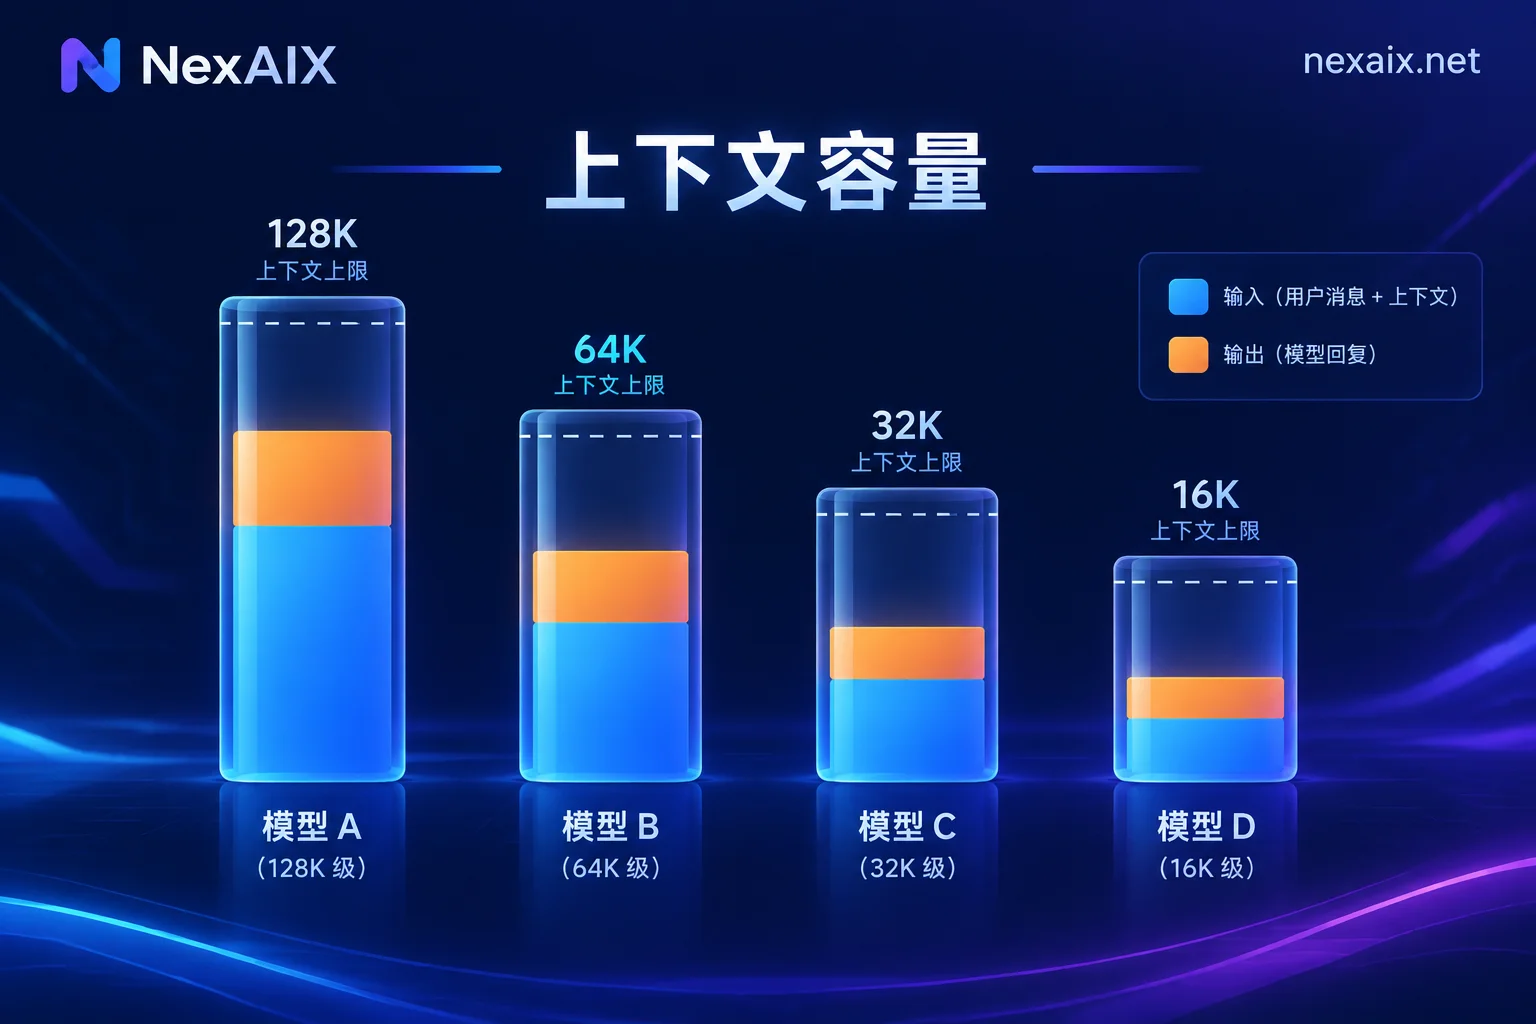
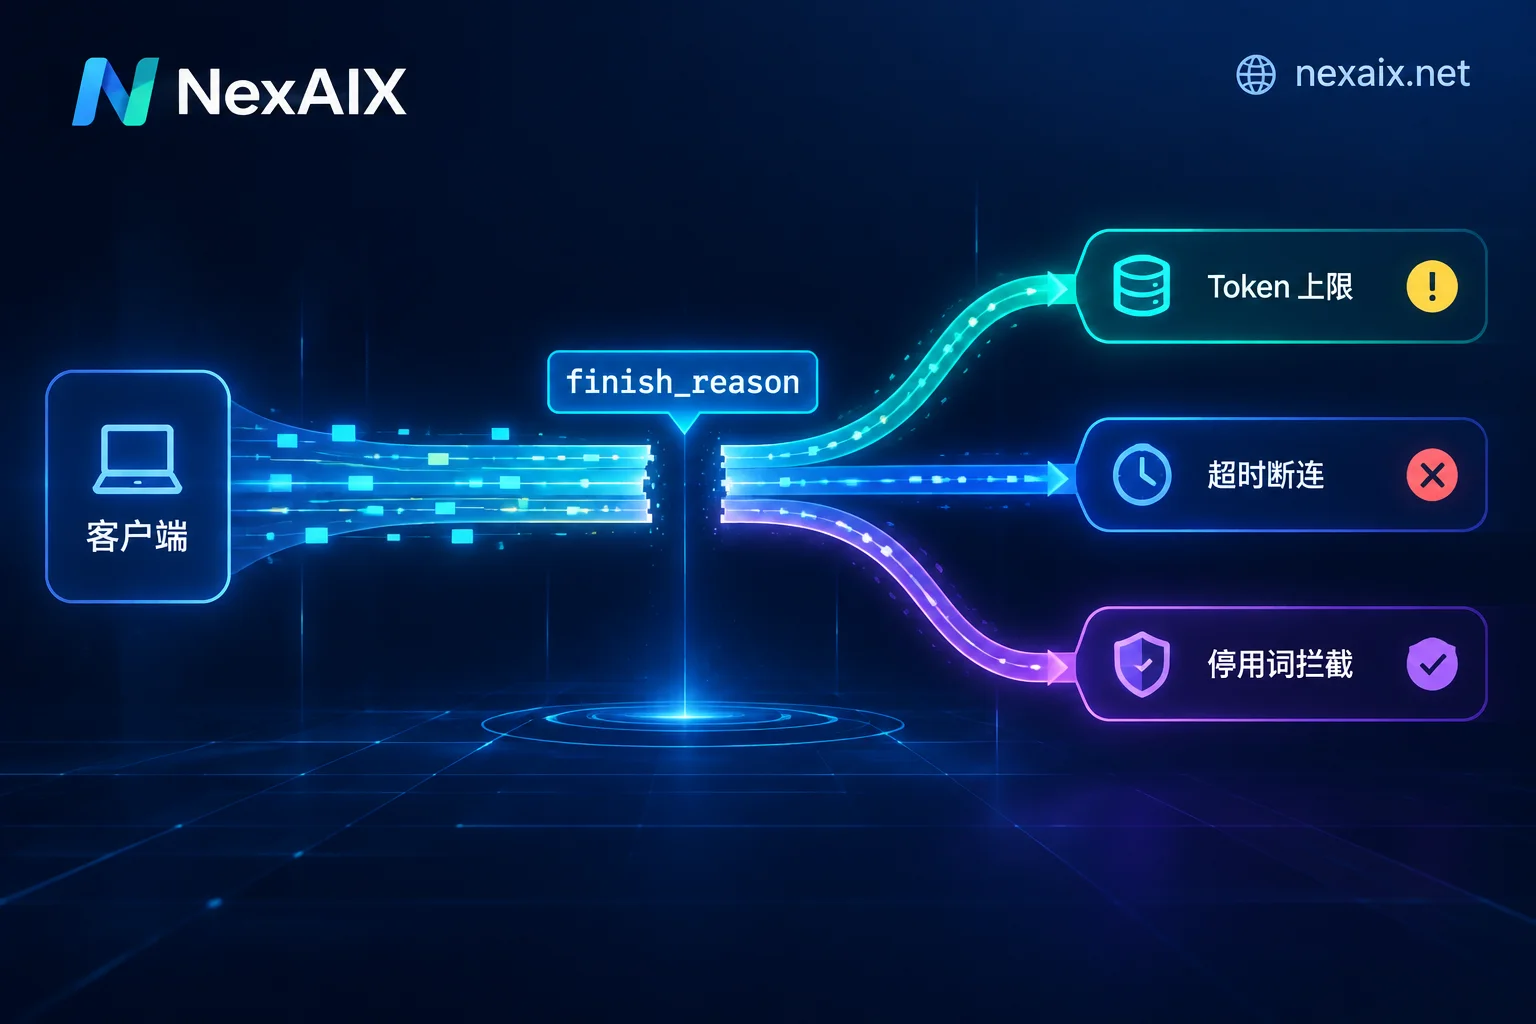
输出被截断(句子写一半、JSON 不闭合、流式中断)通常只有四类原因:撞上 Token 上限、推理模型的思维链吃掉了输出额度、任务本身超出模型单次最大输出、以及客户端或代理超时。本文按“先看 finish_reason 判断类别,再改对应参数”的顺序给出具体做法,包括 max_tokens/max_completion_tokens 与上下文窗口的关系、续写循环的写法、流式超时设置,以及 stop 参数和安全过滤造成的假截断排查。