 NexAIX-官方博客
AI API 故障排查:从 401、404、429 到超时、截断和降配怀疑,按顺序定位
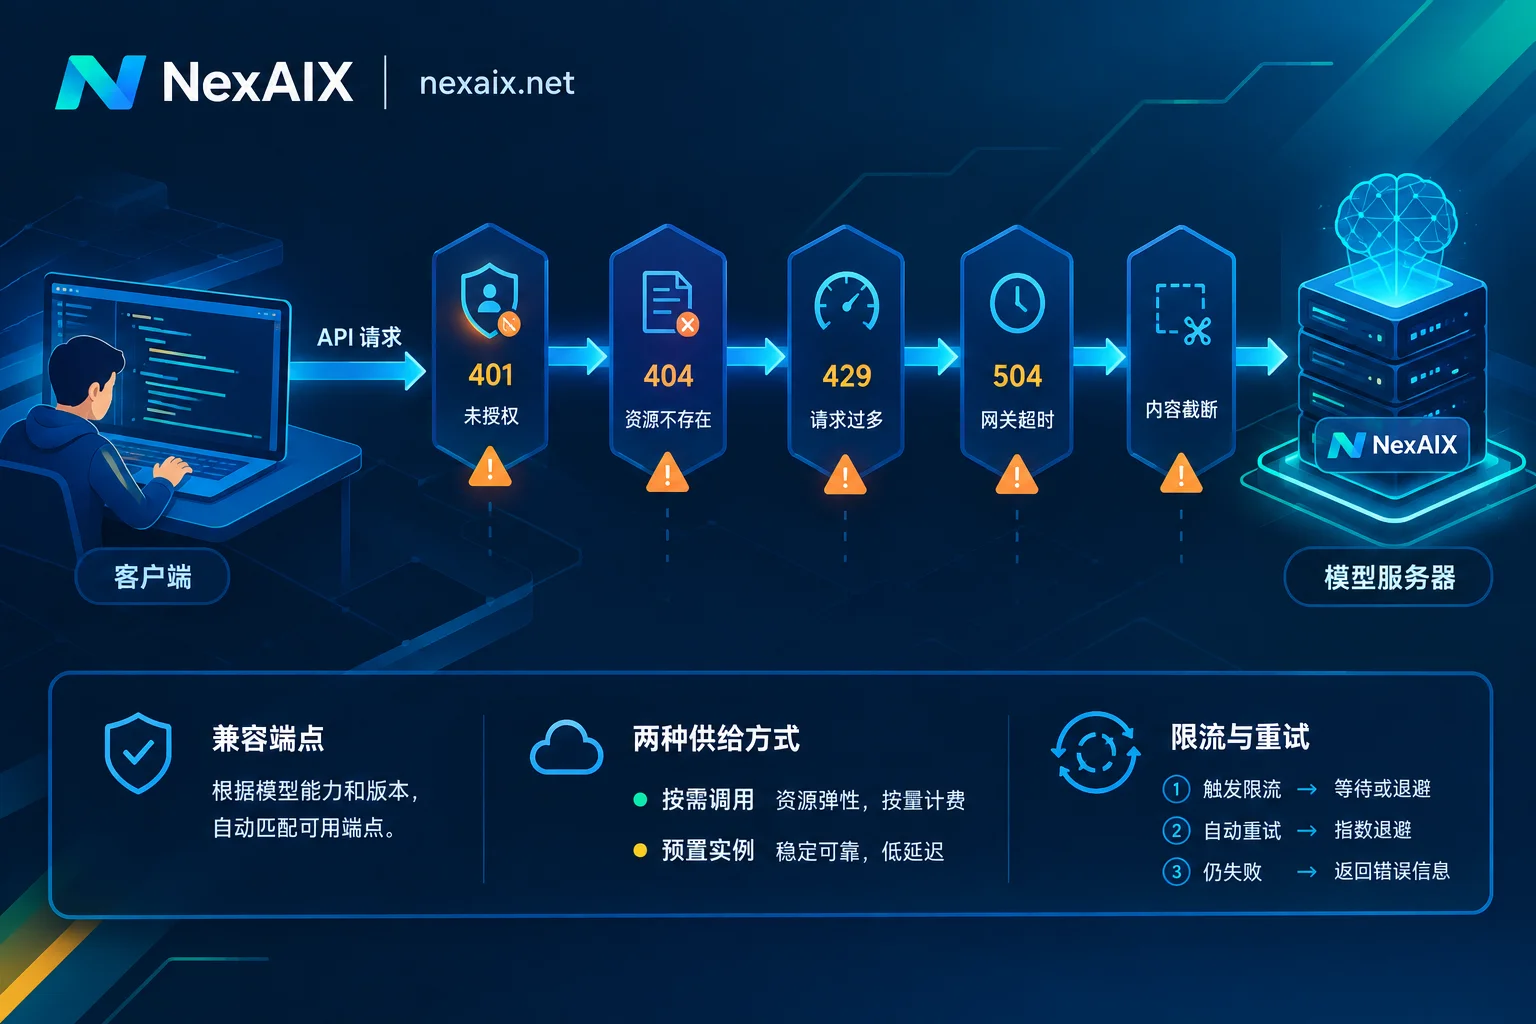
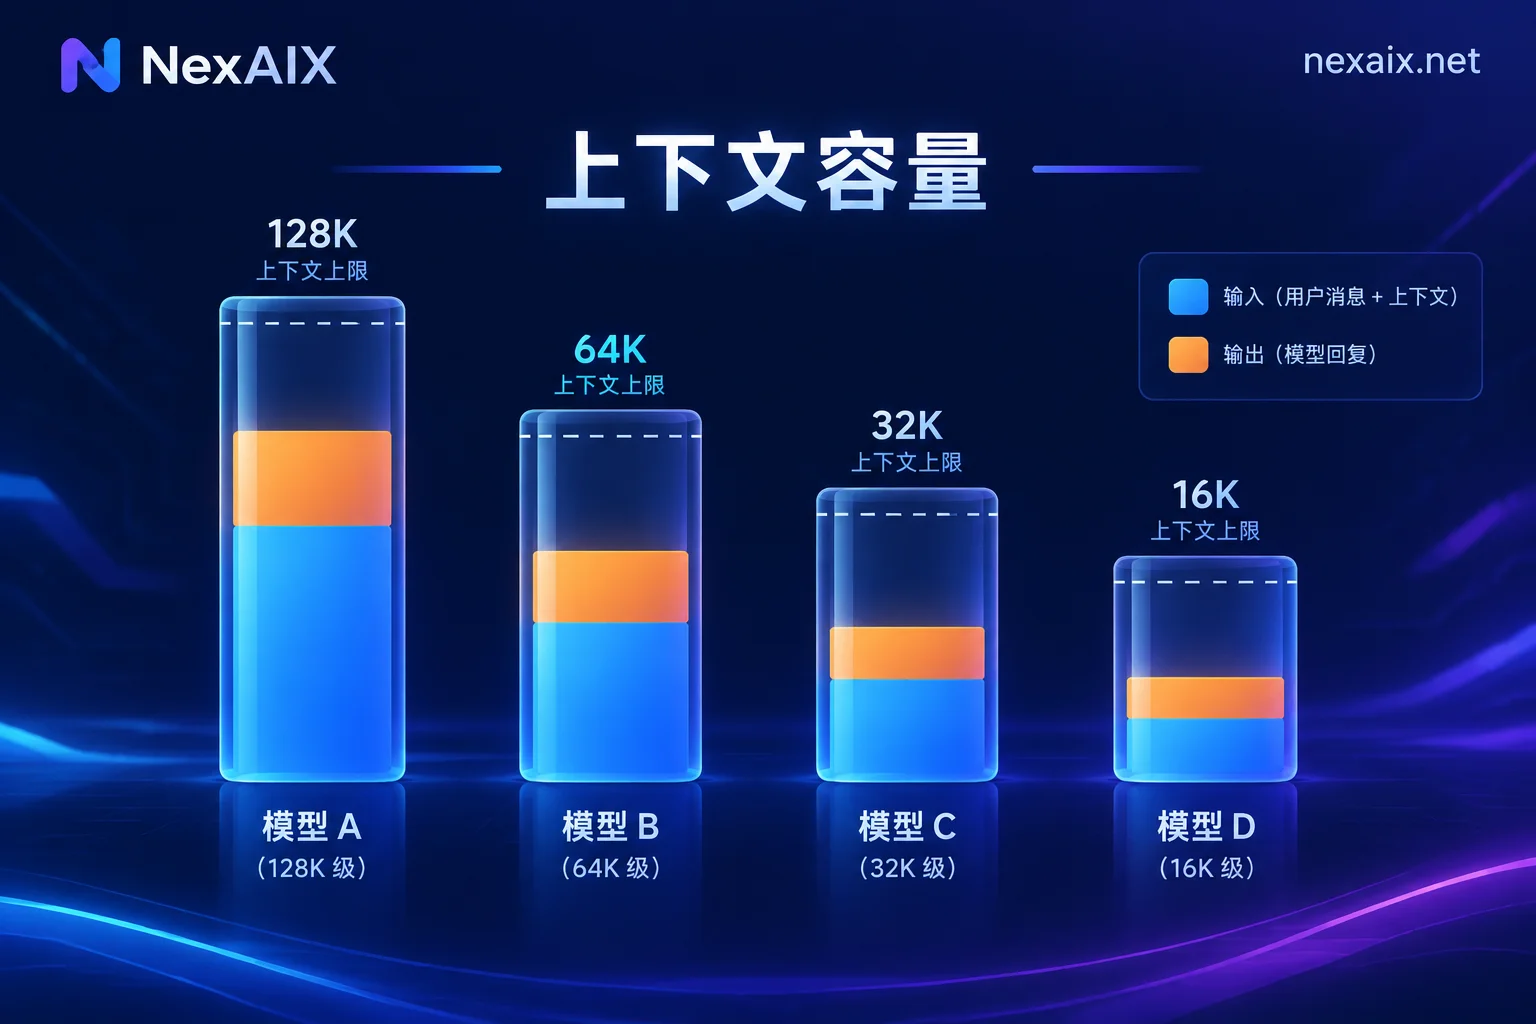
调用大模型 API 出错时,先看状态码和响应体里的错误类型,再用最小请求判断问题在客户端还是服务端。本文按认证、路径与模型 ID、限流与配额、5xx 与超时、上下文截断、降配验证的顺序,说明每类问题的判断方法和对应处理。

调用大模型 API 出错时,先看状态码和响应体里的错误类型,再用最小请求判断问题在客户端还是服务端。本文按认证、路径与模型 ID、限流与配额、5xx 与超时、上下文截断、降配验证的顺序,说明每类问题的判断方法和对应处理。
