 NexAIX-官方博客
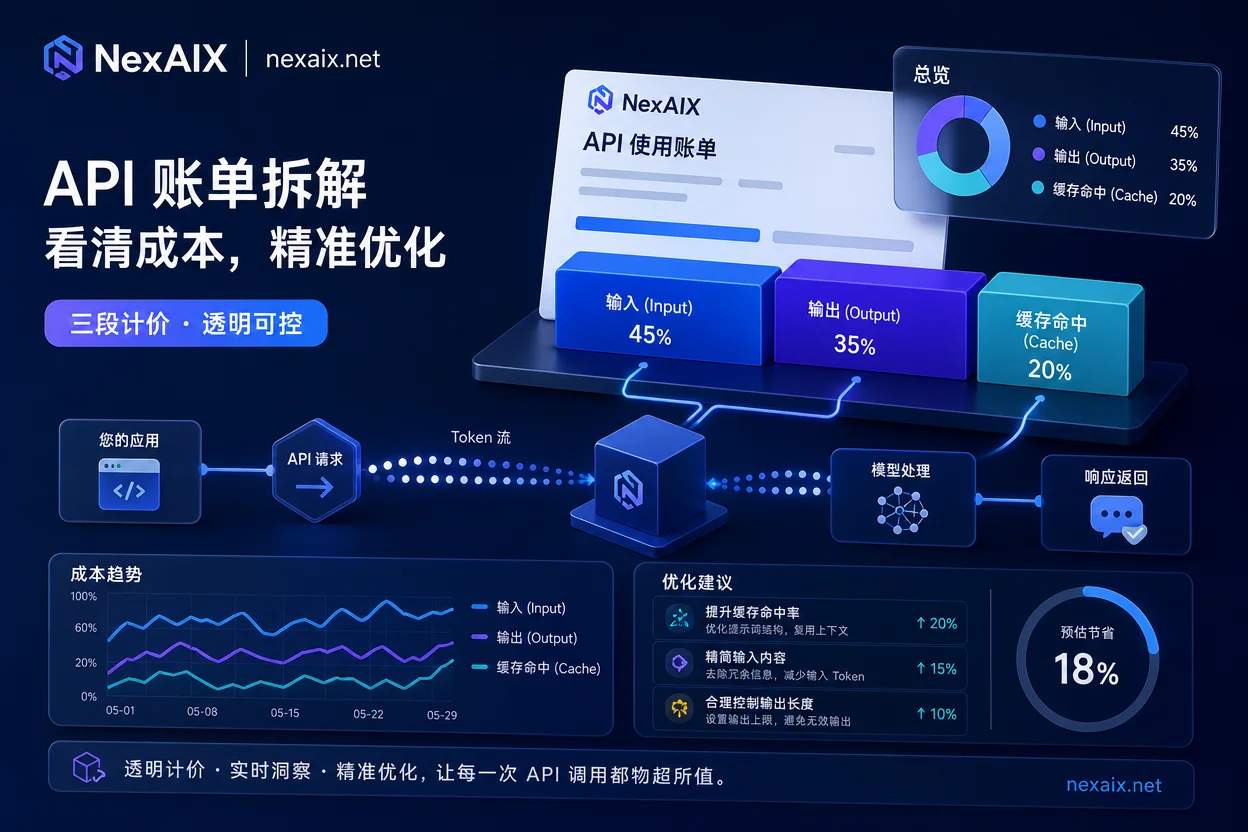
AI API成本优化怎么算?缓存命中与上下文预算指南
AI API成本优化的核心不是换更便宜的模型,而是先把账单拆开:单次请求价格 = Cache Miss 输入 token 数 × 单价 + Cache Hit 输入 token 数 × 单价 + 输出 token 数 × 单价。从 2026 年 7 月 31 日 DeepSeek-V4-Flash-0731 公测公布的三档单价看,Cache Hit 与...
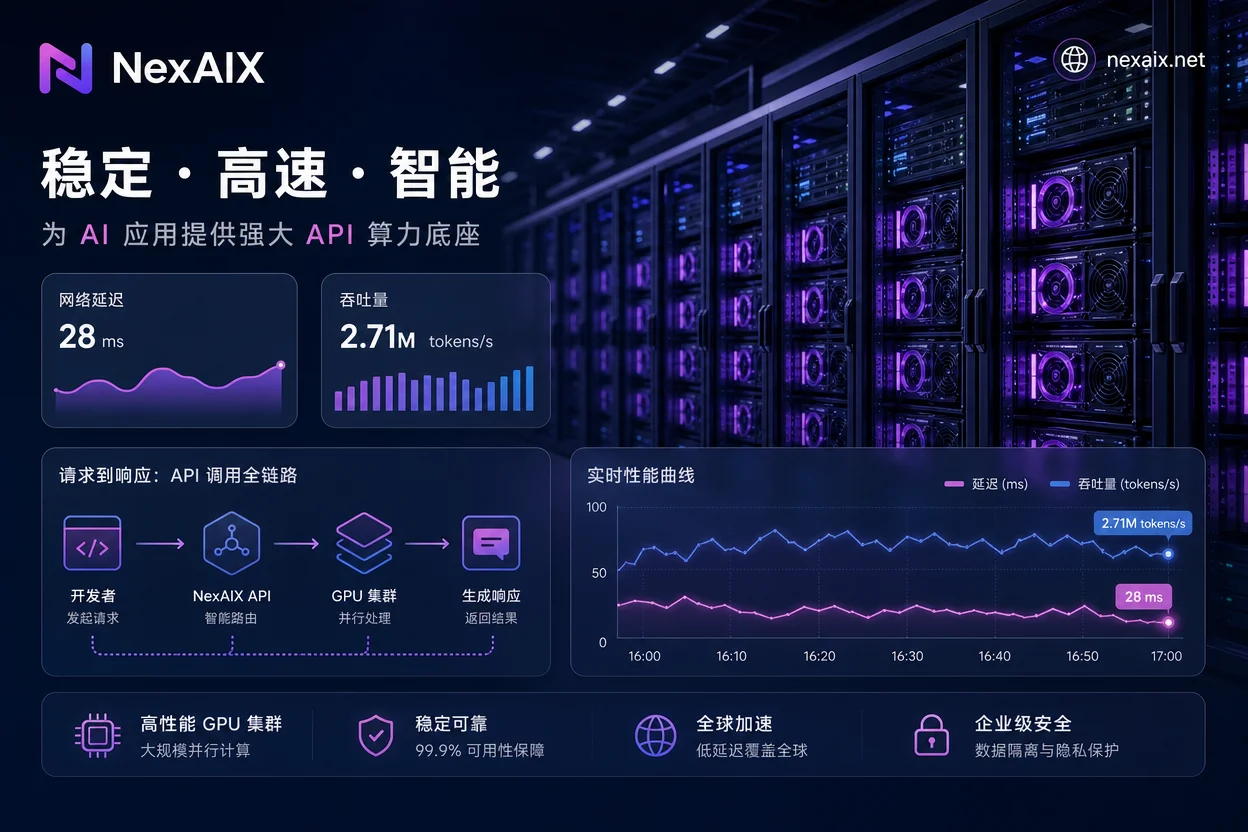
DeepInfra 的 TTFT/吞吐/E2E 框架:如何用压测识别自有算力AI API 与中转站的性能掺水
同一个模型名,为什么你的首 Token 要多等几秒?2026 年 4 月,多家服务商针对 DeepSeek V4 Pro(1.6 万亿参数 MoE,支持 1M 上下文)的实测显示,TTFT 从低于 1 秒到数秒不等,输出吞吐从 30 到 160+ tok/s 不等。这并非模型本身的问题,而是算力架构与节点搭建的差异。如果你自建 Agent 或 RAG ...
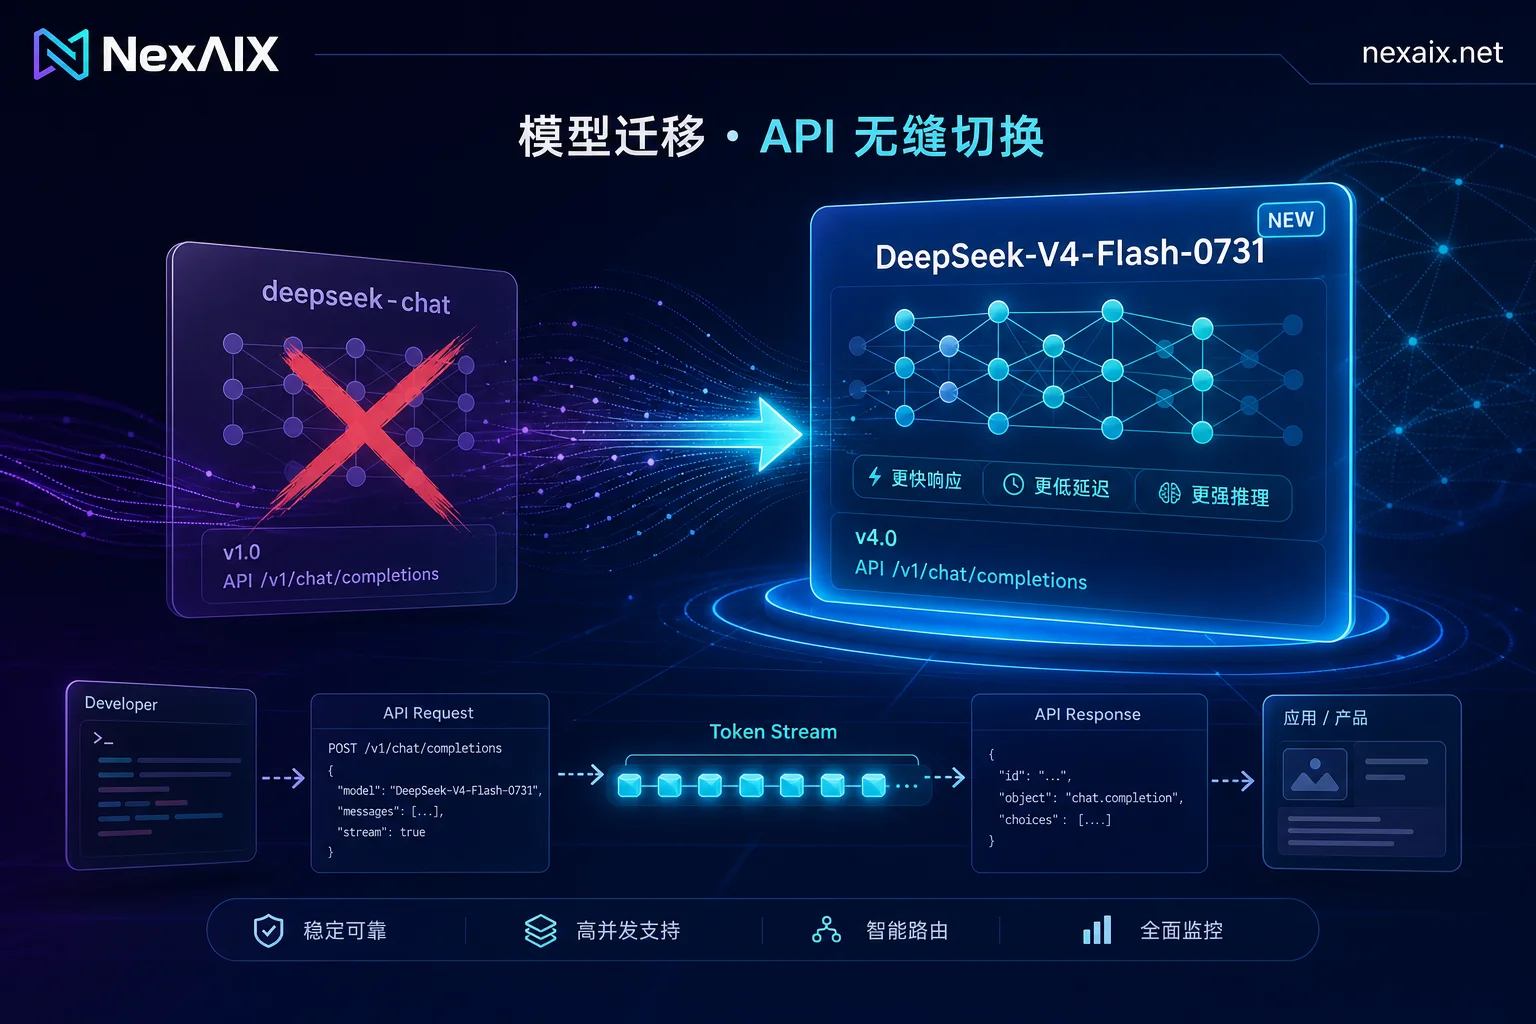
deepseek-chat 别名退役后怎么改:OpenAI兼容API 的 model 迁移路径与回归验证清单
2026 年 7 月 24 日,DeepSeek 正式停用了 deepseek-chat 与 deepseek-reasoner 两个历史 API 别名;一周后的 7 月 31 日,官方上线了 DeepSeek-V4-Flash-0731 公测版,并宣布其原生支持 Responses API。对于所有通过 OpenAI兼容API 接入生产环境的团队而言...

