 NexAIX-官方博客
在将大模型应用推向生产环境时,几乎所有技术团队都会经历一次甚至数次由 AI API限流(Rate Limiting)引发的线上告警。明明监控面板上的每秒查询数(QPS)并不高,接口却突然大面积返回 HTTP 429 Too Many Requests;或者后台刚跑起一个批处理任务,前台的实时客服机器人就陷入了无限转圈。
传统 Web 接口的限流大多只看请求频次,而大模型 API 的限流是一个涉及请求频次(RPM)、Token 吞吐(TPM)与在途并发数(Concurrency)的三维立体模型。如果不理清这三个维度的耦合关系,也不了解底层算力渠道的配额分配逻辑,单纯靠客户端“死循环重试”只会加剧雪崩。
本文将从一线工程排查视角出发,拆解 AI API 限流的触发机制,剖析常见的渠道隐性陷阱,并给出从客户端平滑退避、按 Key 边界隔离到多模型算力调度的完整解法。
一、 为什么请求量不高也会触发 429?先拆解三维限流机制
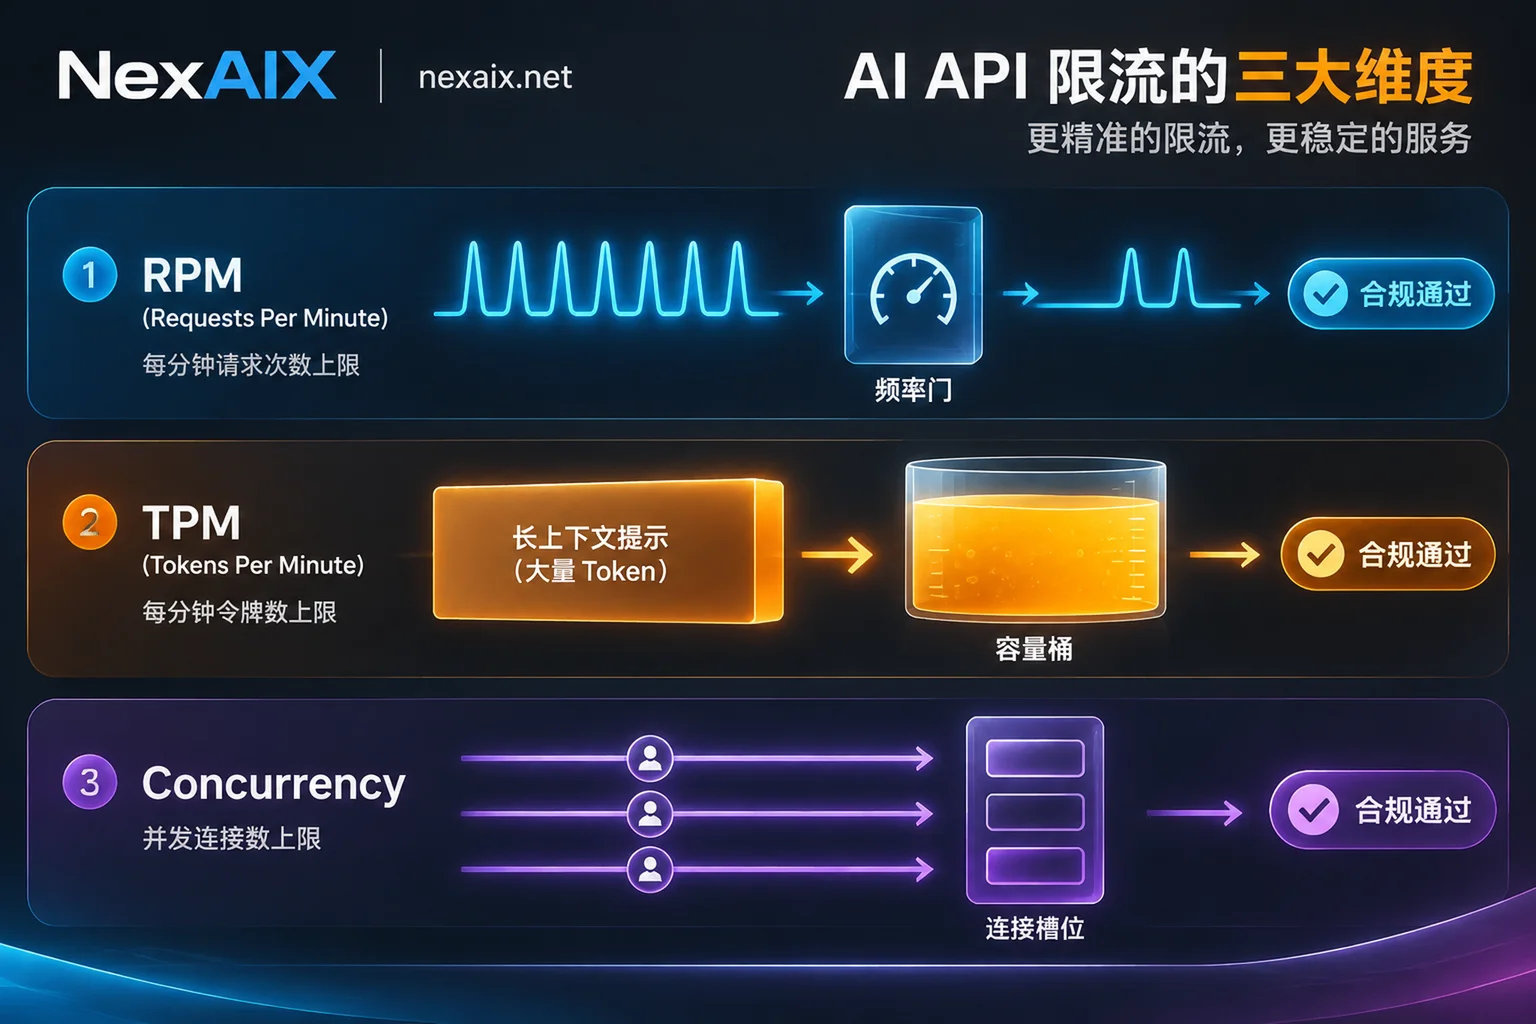
当线上收到 429 状态码时,第一步不是改重试次数,而是判断到底撞上了哪一堵墙。主流大模型接口通常在三个独立维度上进行限速,任何一个维度触顶都会立即拒绝请求。
1. RPM(每分钟请求数)与秒级突发限制
RPM(Requests Per Minute)衡量的是单位时间内的调用频次。很多开发者认为“60 RPM 意味着我可以在第 1 秒内瞬间并发 60 个请求,然后休息 59 秒”。但在实际工程中,主流平台除了按分钟统计,往往还配合了令牌桶或秒级 RPS(RPM/60)突发保护机制。
- 典型触发场景:定时任务整点唤醒、批量数据打标、文本分块并行向量化或摘要。
- 表象特征:短时间密集请求后立刻报错,暂停几秒后又恢复正常,呈现明显的周期性锯齿状报错。
2. TPM(每分钟 Token 数):长上下文时代的隐形杀手
随着百万级上下文模型和多模态输入的普及,TPM(Tokens Per Minute)成了最容易被误判的限流维度。
- 典型触发场景:RAG 检索注入了数万字的知识库切片、多轮 Agent 循环携带了冗长的历史消息树、或者传入了高分辨率多模态图像序列。
- 表象特征:监控显示每分钟只有寥寥几次请求,但每次请求都必然触发 429。这是因为单次输入加上预估输出(
max_tokens)瞬间吃光了当前分钟的 Token 预算(此外,超长输入还会导致首 token 延迟和单次费用随输入长度明显上升)。关于长上下文场景下的显存与吞吐治理,可以参考我们此前的《长上下文 API 生产落地指南》。
3. 在途并发上限(Concurrent Requests):慢思考模型的瓶颈
并发限制看的是“同一时刻有多少个请求已经发出、但尚未结束响应”。它与 RPM 截然不同。
根据利特尔法则(Little's Law),在途并发数 = 请求到达率 × 平均响应耗时。假设你每秒只发 2 个请求(完全未超 RPM),但如果调用的是深度推理模型或生成万字长文,单次请求耗时需要 15 秒,那么第 15 秒时你的在途并发请求数就会累积到 30 个。
- 典型触发场景:使用强推理模型处理复杂代码生成、长文档全量翻译、未开启流式输出导致连接长时间占用。
- 表象特征:当上游推理变慢时,客户端线程池或协程池迅速被占满,随后新发出的请求成批失败。
| 限流维度 | 核心计量指标 | 常见诱因 | 核心缓解手段 |
|---|---|---|---|
| RPM(请求频次) | 窗口内调用次数 | 整点跑批、无间隔循环调用 | 客户端令牌桶平滑、错峰调度 |
| TPM(Token 吞吐) | 输入 + 输出 Token 总和 | 超长 Prompt、全量历史上下文堆叠 | 精简上下文、合理收敛 max_tokens |
| 并发数(Concurrency) | 同时处于连接中的请求数 | 长输出生成耗时久、深度推理耗时长 | 信号量(Semaphore)控制并发、流式读取 |
二、 比 429 更危险的,是“不规范限流”引发的生产事故
在自研或接入第三方模型网关时,标准的 429 其实是一种健康的保护信号。真正让技术负责人头疼的,是底层渠道不透明或网关策略不规范导致的次生灾害。
1. 账号级共享配额导致的“内部误伤”
不少云厂商或聚合平台采用“主账号维度合并限流”的策略——账号下所有业务空间、所有 API Key 共享同一个 RPM/TPM 水池。如果数据分析团队在后台临时跑了一个批量清洗脚本,瞬间打满配额,前端正在服务真实用户的核心交易助手就会立刻因为 429 而瘫痪。缺乏 Key 级别的独立配额隔离,意味着任何单一模块的流量毛刺都会演变成全局故障。
2. 无限期挂起(Hanging)拖垮调用链
部分基于逆向网页协议或劣质号池拼凑的中转站,在遇到上游限流或账号封禁时,不会立即向客户端返回 429,而是将 HTTP 连接挂起,在后台轮询重试几十个免费账号。这种“假死”状态会让客户端的超时控制失效,迅速耗尽应用服务器的连接池,引发整条 Agent 调用链雪崩(详见《稳定 AI API 生产落地指南:告别 Agent 调用链雪崩、隐式降配与挂起故障》)。
3. 满载时“偷梁换柱”隐式降配
还有一些主打“永不限流”的黑盒路由平台,当主模型配额满载时,为了不报错,会在后台悄悄把用户的请求转发给参数量更小、精度被大幅阉割(例如从 BF16 降为低比特量化)的廉价模型,甚至暗中截断用户的输入上下文。业务看似没报错,但输出质量断崖式下跌,排查起来极其困难。
三、 生产级 AI API 限流应对与治理方案
要让大模型应用在高并发下稳健运行,需要服务端明确边界与客户端优雅制御双向配合。以下是经过生产验证的四步治理架构:
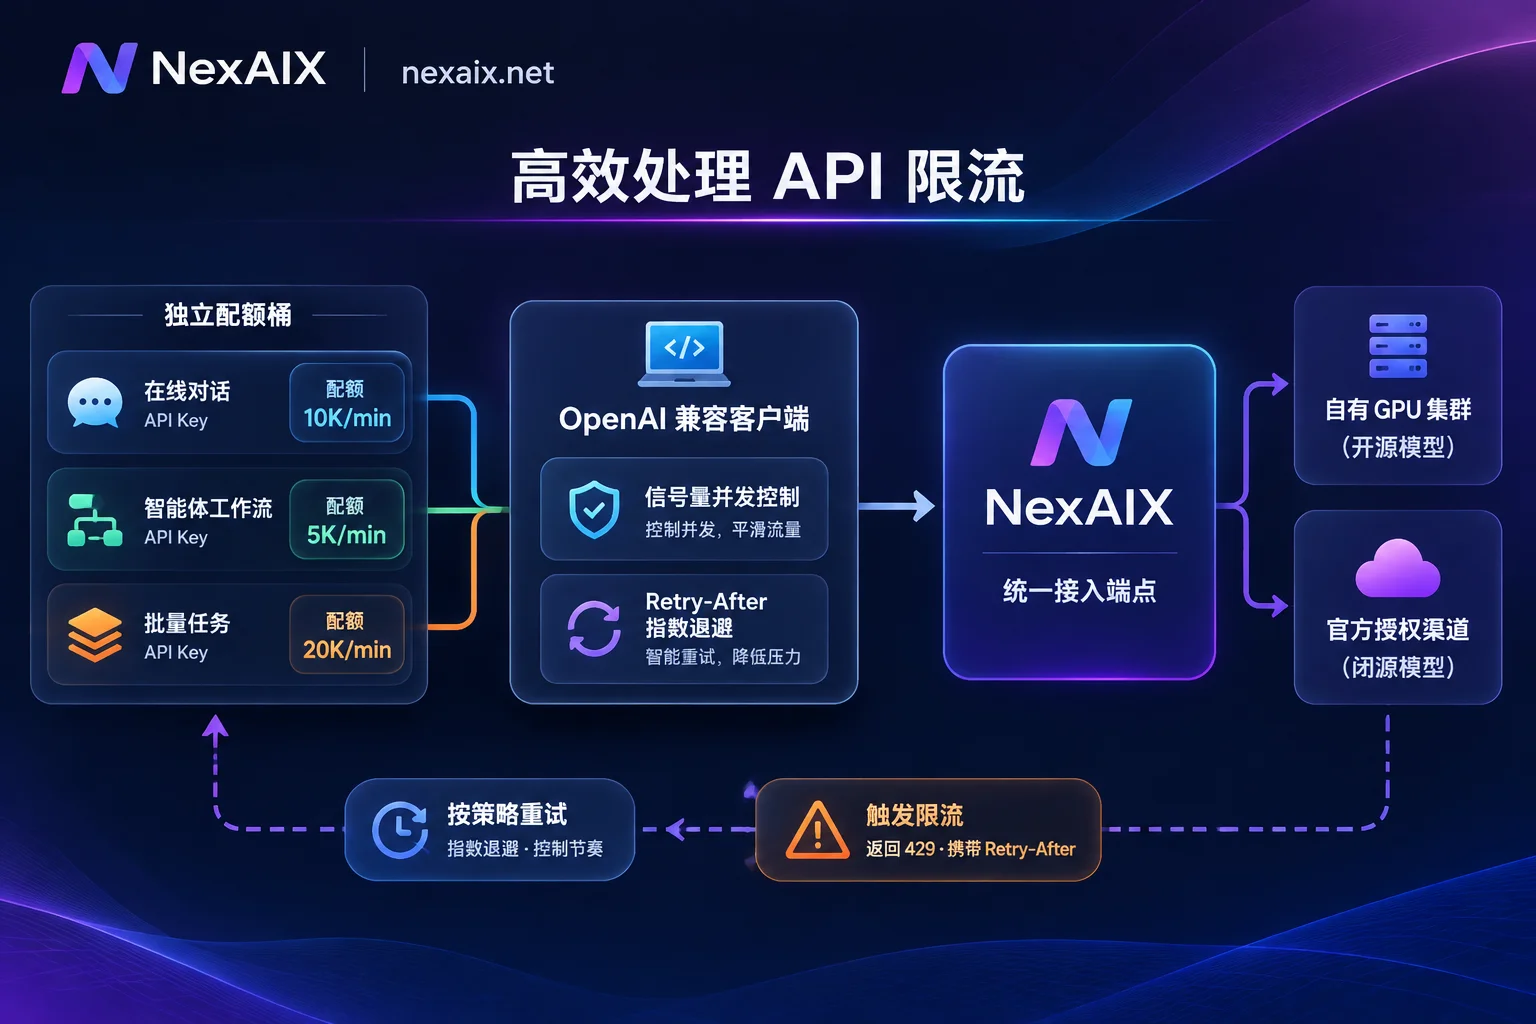
1. 接入明确返回 429 与 Retry-After 的透明网关
在选型 API 基础设施时,“确定性”高于一切。在 NexAIX 的高吞吐架构设计中,我们严格遵循透明限流原则:
- 绝不挂起与掉包:当请求触及配额上限或上游满载时,网关会立即返回标准的
HTTP 429状态码,并在响应头中携带明确的Retry-After建议等待时间。我们绝不会无限期挂起连接,更不会在满载时偷偷将请求替换成更便宜的模型(您随时可以通过不降配自查页面的四种方法核验返回体中的model字段与实际输出质量)。 - 全线支持流式输出(Streaming):全部模型均支持按 OpenAI 规范流式返回,帮助客户端尽早接收首 Token、监控连接活性,避免长耗时请求变成黑盒等待。
2. 客户端实现:并发信号量 + 优先读取 Retry-After 的退避机制
在代码层,切忌裸写 for 循环暴力重试。应当结合异步信号量(控制最大在途并发)与遵守 Retry-After 的指数退避策略。
由于 NexAIX 完整按 OpenAI Chat Completions 规范实现,已有项目只需将 base_url 改为 https://api.nexaix.net/v1 并换上 NexAIX 的 Key 即可接入。下面是一个带并发控制与标准 429 退避的 Python 生产级调用示例:
import asyncio
import random
import time
from openai import AsyncOpenAI, RateLimitError, APIStatusError

# 1. 仅需替换 base_url 与 api_key 即可无缝接入 NexAIX
client = AsyncOpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key="your_nexaix_api_key",
    max_retries=0  # 关闭 SDK 默认盲目重试,由自定义逻辑精准接管 Retry-After
)

# 2. 使用 Semaphore 严格限制在途并发数,防止慢请求堆积冲垮并发上限
MAX_CONCURRENT_REQUESTS = 10
semaphore = asyncio.Semaphore(MAX_CONCURRENT_REQUESTS)

async def call_model_with_backoff(messages: list, model: str = "glm-5.2", max_attempts: int = 5):
    async with semaphore:
        for attempt in range(1, max_attempts + 1):
            try:
                response = await client.chat.completions.create(
                    model=model,  # 切模型只改 model 字段,如 glm-5.2 或 gpt-5.6
                    messages=messages,
                    temperature=0.7,
                    max_tokens=2048,
                    stream=False
                )
                return response.choices[0].message.content

            except RateLimitError as e:
                if attempt == max_attempts:
                    # 提取请求 ID 便于联系技术支持快速排障
                    req_id = e.response.headers.get("x-request-id", "unknown")
                    raise RuntimeError(f"达到最大重试次数仍触发限流,Request ID: {req_id}") from e

                # 3. 优先读取服务端返回的 Retry-After 响应头
                retry_after = e.response.headers.get("retry-after")
                if retry_after and retry_after.isdigit():
                    wait_time = float(retry_after) + random.uniform(0.1, 0.5)
                else:
                    # 若无明确指示,执行带随机抖动(Jitter)的指数退避
                    wait_time = (2 ** attempt) + random.uniform(0.1, 1.0)

                print(f"[429 限流保护] 第 {attempt} 次退避,等待 {wait_time:.2f} 秒后重试...")
                await asyncio.sleep(wait_time)

            except APIStatusError as e:
                req_id = e.response.headers.get("x-request-id", "unknown")
                print(f"API 异常状态码 {e.status_code}, Request ID: {req_id}")
raise排障提示:在 NexAIX 的每一次 API 调用都会返回唯一的请求 ID(且我们在内存转发后立即释放对话内容,不记录任何 Prompt 与 Completion 落盘,只保留请求 ID、模型名、token 计数、时间戳与状态码)。线上遇到限流或状态码异常时,带着请求 ID 联系我们即可秒级定位原因。
3. 架构层治理:按 Key 独立配额隔离,阻断故障传染
为了彻底解决“后台跑批拖垮前台业务”的问题,必须在身份鉴权层做好故障隔离域划分。
在 NexAIX 中,每把 API Key 均拥有独立配额、独立权限与独立用量账单:
- 业务解耦:您可以为“线上实时对话”、“内部办公助手”和“夜间离线批处理”分别创建不同的 API Key。每把 Key 各自计算 RPM、TPM 和并发上限,批处理任务就算触发 429,也绝不会挤占线上实时核心业务的配额。
- 安全与成本审计:一旦某个环境的 Key 意外泄露,可以单独吊销而不影响其他服务;财务对账时,账单支持按 Key 与按模型分项导出明细(延伸阅读:《AI API 成本优化实战指南:从 Agent 多模型分层、隐性损耗排查到多 Key 账单治理》)。
4. 容量层破局:结合“自有算力部署”与“官方授权渠道”规划吞吐
当业务体量增长、默认配额确实不够用时,单纯靠客户端退避已经无法解决根本的吞吐赤字。这时候需要看清不同模型的底层供给逻辑,针对性扩容(关于两种供给模式的详细对比,可参阅《开源权重模型 API 和官方授权渠道有什么区别》)。
在 NexAIX 模型广场,我们只提供两种透明、可审计的供给方式(详见《透明供给与自查指南》),拒绝任何号池与逆向渠道:
- 官方授权渠道(闭源模型):
涵盖 Claude、GPT-5.6、Grok、Gemini 等系列。走厂商官方商用授权,有合同、有发票、可审计。这类模型的总容量受上游厂商配额约束(同时上游数据留存按各厂商条款执行,例如目前 Claude 的 Opus 5 模型页标明支持零数据保留,Fable 5 目前有 30 天留存)。 - 自有算力部署(开源权重模型):
涵盖 Kimi、GLM、DeepSeek、MiniMax、Qwen、gpt-oss 等官方发布的开源权重系列。由 NexAIX 直接部署在自建与自租机房的自有 GPU 集群上,自己运维,不转售第三方额度。每个模型详情页(如 GLM-5.2 模型页,注意 URL slug 将模型 ID 里的点替换为横线,而请求体中仍传glm-5.2)都清晰标注了上下文窗口、最大输出与推理精度(如 BF16、FP8、MXFP4 等)。
高并发混合调度建议:
因为 NexAIX 是单一供应方与单一端点,不会在后台擅自替用户把 429 请求自动转给其他模型,由开发者完全掌控路由决定权。您可以用同一把 Key、同一个接口规范,将对实时吞吐要求极高、并发量巨大的任务主力分配给运行在 NexAIX 自有 GPU 集群上的开源权重模型(如 DeepSeek、GLM 或 Qwen 系列),并在收到 429 时由您的业务网关决定是退避排队,还是将 model 字段切换至备选模型。
四、 遇到配额瓶颈?按需申请扩容与专属资源池
限流规则本身不是为了卡住业务,而是为了保障多租户生产环境的确定性。随着您的应用从原型验证走向规模化放量,NexAIX 提供平滑的容量升级路径:
- 在线提额申请:每把 Key 默认设有基础的 RPM、TPM 和并发上限(具体数值请以官网及控制台说明为准)。如果您的生产业务需要更高配额,可直接发起申请,我们会根据自有集群与上游配额的实际容量快速答复。
- 清单外模型定制与独立资源池:如果您需要的开源权重模型不在当前列表中,可以向我们提交型号与预计用量(发送邮件至
[email protected]),我们在评估算力后会回复上线排期。对于有严格合规与高并发保障要求的企业团队,我们支持签署正式合同、服务协议(SLA)与数据处理协议(DPA),开具增值税发票,并可评估定制独立资源池与私有化部署方案。
如果您正在为线上频繁出现的 429 限流告警、渠道响应挂起或配额互相挤占而困扰,欢迎直接前往 NexAIX 控制台(api.nexaix.net) 使用邮箱注册。无需繁琐的企业资质审核,注册即送测试额度,支持 OpenAI SDK、LangChain、LlamaIndex、Vercel AI SDK、Dify、Cherry Studio、Cline、OneAPI 等主流工具一键填入 https://api.nexaix.net/v1 立即验证,让每一次高并发调用都跑在透明、可控的生产级算力之上。