NexAIX NexAIX-官方博客
  • 博客首页
    • 默认分类
  • 关于
返回首页
EN
NexAIXNexAIX-官方博客
EN
  • 返回首页
  • 博客首页
  • 关于
    • 默认分类 (103)

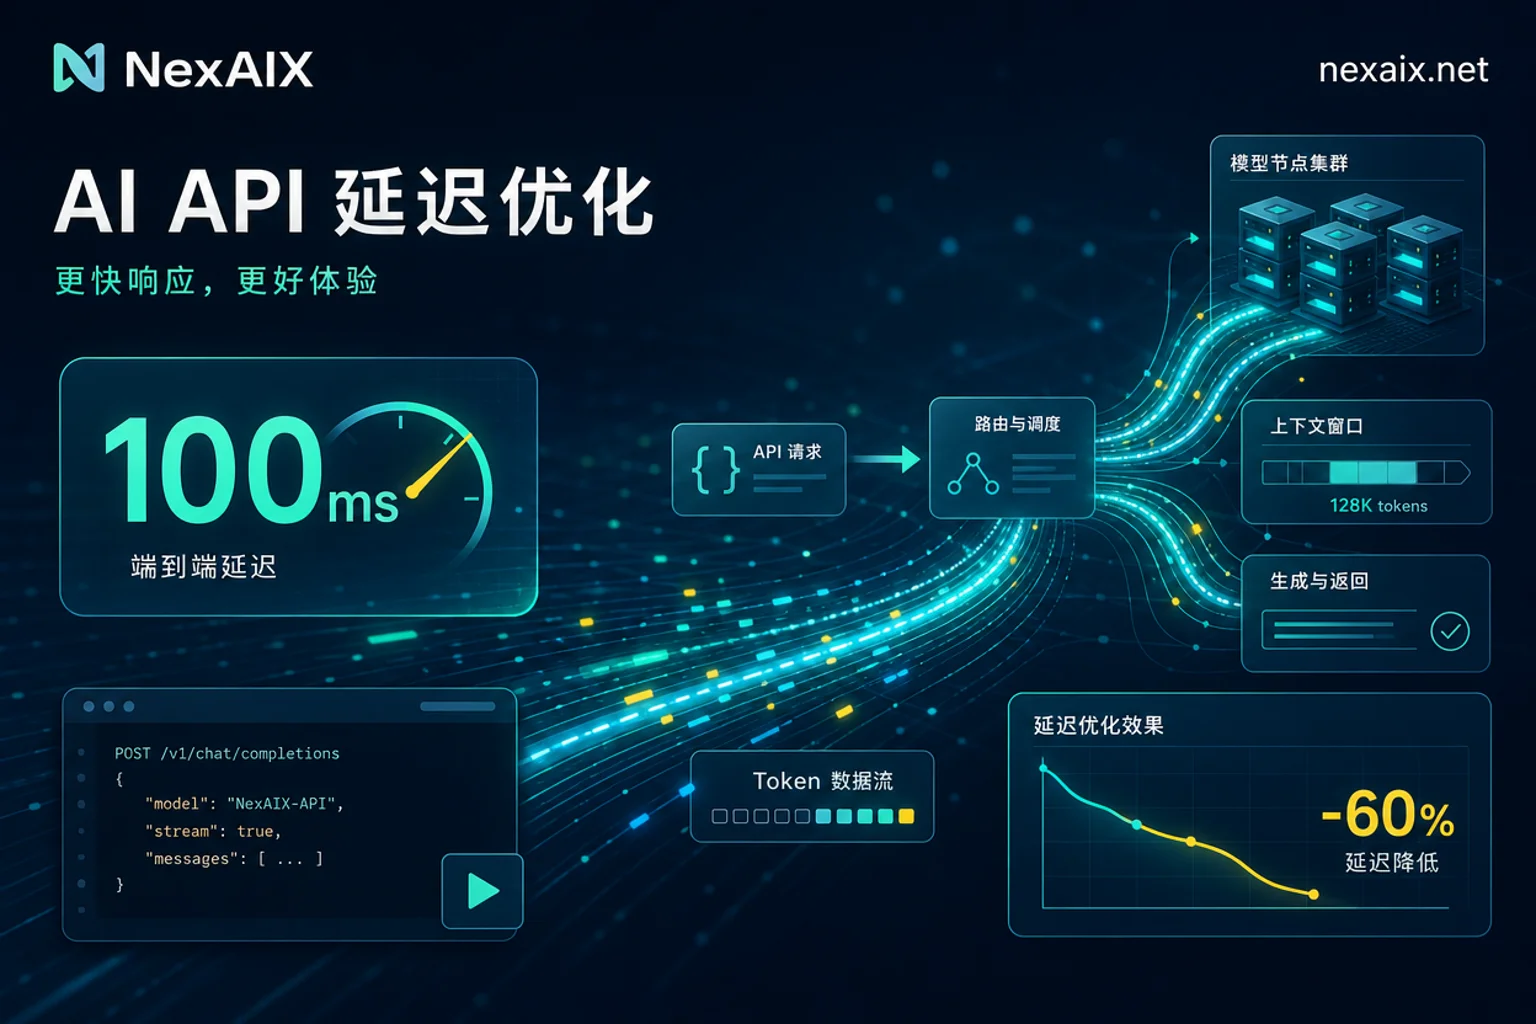
AI API延迟怎么压到100ms内?拆解可控环节与达标线

AI API延迟怎么压到100ms内?拆解可控环节与达标线

AI API延迟主要由客户端可控与服务商推理栈决定两部分构成,先分清TTFT与端到端再谈优化。2026年6月,Together AI与NVIDIA展示的推理栈已能把Agent前64词输出压进100ms,说明延迟优化正从“选模型”转向“选推理栈”。先分清三个数:TTFT、输出吞吐与端到端各自决定什么体验讨论AI API延迟,第一步不是调参,而是把三个容易...

默认分类 2026-08-13 187人浏览
OpenAI兼容API TTFT AI API延迟 投机解码 语音Agent
admin

admin

文章103
  • 大模型API选型之惑:当“降配”与“留存”成为生产环境的隐形杀手

    大模型API选型之惑:当“降配”与“留存”成为生产环境的隐形杀手

热门文章

  • AI API中转站锁定模型关闭自动路由的请求配置与验证

    AI API中转站锁定模型关闭自动路由的请求配置与验证

    677 次阅读

  • AI API成本优化怎么算?缓存命中与上下文预算指南

    AI API成本优化怎么算?缓存命中与上下文预算指南

    648 次阅读

  • AI中转站掺水怎么查:4类形态+可复现验证步骤

    AI中转站掺水怎么查:4类形态+可复现验证步骤

    631 次阅读

  • DeepSeek V4 API 接入:Pro 与 Flash 版本选择、调用参数与降配验证

    DeepSeek V4 API 接入:Pro 与 Flash 版本选择、调用参数与降配验证

    590 次阅读

  • MiniMax M3 API 接入指南:1M 上下文调用、reasoning 回传与多模态验证

    MiniMax M3 API 接入指南:1M 上下文调用、reasoning 回传与多模态验证

    578 次阅读

热门标签

模型选型 API接入 OpenAI兼容API OpenAI兼容 Agent开发 API 接入 长上下文 工具调用 流式输出 生产环境 故障排查 OpenAI 兼容接口 DeepSeek 限流 成本优化 API 迁移 大模型API GPT-5.6 多模型接入 AI API

其它

  • 登录
  • 文章

© 2026 NexAIX-官方博客 . Theme Once

  • 首页